
Bygg vurderingsrubrikker som lærere kan pilotere og skalere med AI
Vurderingsscoringsskjemaer er strukturerte verktøy som gjør subjektiv vurdering om til en konsekvent og forsvarlig prosess. Ethvert funksjonelt rubrikk har fire deler: en oppgavebeskrivelse, kriteriene du måler, prestasjonsnivåer som markerer kvalitetsbånd, og deskriptorer som forklarer hva hvert nivå faktisk ser ut som. Denne guiden tar deg gjennom å bygge ett, pilotteste det mot ekte studentarbeid og gjennomføre pålitelighetssjekker som holder flere sensorer på samme side.
TL;DR:
- Pålitelig vurdering krever at kriteriene begrenses til de mest betydningsfulle aspektene, vanligvis tre til seks, for å unngå forvirring og opprettholde konsistens.
- Normeringssessjoner hjelper med å kalibrere sensorer ved å vurdere eksempelarbeid uavhengig og diskutere avvik for å klargjøre tolkningen av deskriptorer.
- Å starte med målbare, observerbare deskriptorer og pilotteste et rubrikk på ekte studentarbeid sikrer nøyaktighet og rettferdighet i vurderingen.
- Å bruke et enkeltpunkts-rubrikk eller et meta-rubrikk reduserer omfangskryp og forenkler opplæring for konsekvent anvendelse på tvers av store vurderingsvolumer.
- KI-drevne vurderingsverktøy kan reprodusere rubrikkriterier konsekvent i stor skala, noe som minimerer menneskelig drift og fremskynder evalueringsprosessen.
Innholdsfortegnelse
- Hva er scoringsrubrikker? De fire delene du trenger
- Slik lager du et scoringsrubrikk steg for steg
- Rubrikkmaler du kan tilpasse i dag
- Karaktersetting for enkeltstudenter kontra vurdering av programresultater
- Normering og pålitelighet: Å holde flere sensorer konsistente
- Beste praksis som holder rubrikker nyttige
- Hvor TalentApproved passer inn i rubrikk-basert vurdering
- Hva jeg har lært om å balansere rubrikkdetaljer mot karaktersettingstid
- Skaler rubrikkpraksisen din med Talent Approved
- Hvor du kan fordype deg i rubrikkdesign
- Kilder
- FAQ
Hva er scoringsrubrikker? De fire delene du trenger
Et scoringsrubrikk er bare så nyttig som strukturen det er bygget på. Hopp over én av de fire kjernekomponentene, og karaktersettingen glir tilbake til gjettverk – nøyaktig det problemet rubrikker er laget for å løse.
Analytiske rubrikker vurderer hvert kriterium på sin egen skala og kombinerer deretter resultatene. Hvis du vurderer en labrapport på hypoteseklarhet, metodologi og dataanalyse separat, bruker du en analytisk modell. Det tar lengre tid å anvende, men forteller studenten nøyaktig hvor de mistet poeng, noe som gjør det til standardvalget for komplekse, utviklingsrettede oppgaver.
Holistiske rubrikker samler alt i én enkelt totalkarakter basert på et generelt inntrykk av kvalitet. De er raske, noe som er grunnen til at emner med store studenttall og tidsbestemte skriveoppgaver baserer seg på dem, men de gir studentene mindre å jobbe videre med når de ønsker å forbedre seg.
Enkeltpunkts-rubrikker beskriver bare «kompetent»-nivået i én kolonne og etterlater plass på begge sider for at sensoren kan skrive spesifikke notater om hvor arbeidet overskred eller kom til kort. De reduserer forberedelsestiden og, ifølge veiledning fra NC States undervisningsressurser, har en tendens til å produsere mer individualisert tilbakemelding enn et fullstendig utfylt rutenett, fordi sensorer skriver med egne ord i stedet for å velge en ferdiglaget formulering.
Valget mellom de tre avhenger av formålet:
- Bruk analytiske rubrikker for porteføljer, avsluttende prosjekter og alle oppgaver med flere distinkte ferdighetsdimensjoner.
- Bruk holistiske rubrikker for vurdering med høyt volum, der hastighet betyr mer enn diagnostisk detalj.
- Bruk enkeltpunkts-rubrikker når du vil ha rask oppsett og rike, individualiserte kommentarer.
- Start fra et meta-rubrikk som et AAC&U VALUE-rubrikk når du trenger et validert, tverinstitusjonelt utgangspunkt, og smalner det deretter inn til oppgavespesifikke kriterier for spesialisert arbeid som en musikk-jury eller lab-prøve.
Slik lager du et scoringsrubrikk steg for steg
Å bygge et rubrikk som faktisk holder under bruk, følger en bestemt rekkefølge. Hopp over et steg, og du finner ut av det under karaktersettingen – da er det dyrt å fikse.
- Start med læringsmålet. Skriv en setning som beskriver oppgaven knyttet til hva studentene skal demonstrere, ikke bare hva de skal levere.
- Velg 3 til 6 kriterier. Mer enn det, og sensorer begynner å skumlese; færre, og du måler egentlig ikke utfallet. Hvert kriterium bør knyttes til noe du faktisk har undervist.
- Sett 3 til 5 prestasjonsnivåer. Utah Techs vurderingskontor anbefaler å holde seg i det området for klarhet og brukervennlighet; flere nivåer enn det, og vurdererne kan ikke pålitelig skille dem fra hverandre.
- Skriv observerbare deskriptorer. «Demonstrerer sterk argumentasjon» er vagt. «Støtter hvert argument med minst to tekstbevis» er observerbart. Cornells Center for Teaching Innovation advarer spesifikt mot ord som «interessant» eller «kreativ», fordi to sensorer vil tolke dem forskjellig hver gang.
- Bestem deg for vekting. Hvis metodologi betyr mer enn formatering, si det med tall. En enkel aggregering kan vekte fire kriterier med 30/30/25/15 prosent i stedet for å dele totalen likt.
- Pilottest på ekte studentarbeid og revider. Cornells veiledning peker på å teste et utkast mot faktiske innleveringer før det ferdigstilles, og praktikere som gjør dette regelmessig, finner at å vurdere tre til ti eksempelbesvarelser vanligvis er nok til å avdekke hvor en deskriptor ikke klarer å skille mellom to tilstøtende nivåer.
Pro-tips: Vurder en bunke med fem besvarelser med ditt utkast til rubrikk før du tar fatt på en eneste ekte karakter. Hvis du ikke konsekvent kan forklare hvorfor en besvarelse havnet i «kompetent» i stedet for «under utvikling», er det deskriptoren som er problemet, ikke studentens arbeid.
Rubrikkmaler du kan tilpasse i dag
Maler sparer tid, men bare hvis du tilpasser språket til ditt fagfelt i stedet for å kopiere det direkte.
Et kompakt analytisk rubrikk for et kort essay kan vurdere Tesisklarhet, Bruk av bevis og Struktur på tvers av fire nivåer: Eksemplarisk, Kompetent, Under utvikling og Begynnende. Vekt hvert kriterium likt til å begynne med, og juster deretter når du ser hvor studentene faktisk sliter. En totalpoengsum på 12/12 blir meningsfull når deskriptorene under hvert nivå er spesifikke nok til at en kollega som vurderer blindt ville lande på samme tall.
Et holistisk rubrikk fungerer godt for en tidsbegrenset respons i klassen. I stedet for separate kriterier skriver du fire eller fem avsnittslange referansebeskrivelser, én per poengsumband, og matcher studentens arbeid med den nærmeste overordnede beskrivelsen. Noen programmer fremskynder dette ytterligere med en «staple»-metode: sorter urangerte besvarelser i grove bunker først, og tildel deretter tall innenfor hver bunke.
En enkeltpunktmal lister opp kriteriene dine til venstre med bare kolonnen «møter forventningene» utfylt. La «under» og «over»-kolonnene stå tomme for håndskrevne notater:
- Kriteriekolonne: navngi ferdigheten (tese, bevis, mekanikk).
- Møter forventningene-kolonne: én klar setning som beskriver solid arbeid.
- Bekymringer/styrker-kolonner: tom plass for målrettede kommentarer.
Å tilpasse disse på tvers av fagfelt handler i stor grad om å bytte ut vokabular. Et rubrikk for lab-prøve erstatter «tesisklarhet» med «hypoteseformulering», mens et rubrikk for presentasjoner legger til et kriterium for stemmebruk som et rubrikk for skriftlige essays aldri ville trengt.
Karaktersetting for enkeltstudenter kontra vurdering av programresultater
En rubrikkpoengsum betyr noe forskjellig avhengig av hvem som leser den. Når du setter karakterer, tilhører tallet én student og driver tilbakemelding på deres spesifikke arbeid. Når du gjør utfallsvurdering, aggregeres de samme rubrikkdataene på tvers av en hel klasse eller et program, og enkeltindividet forsvinner inn i et mønster.
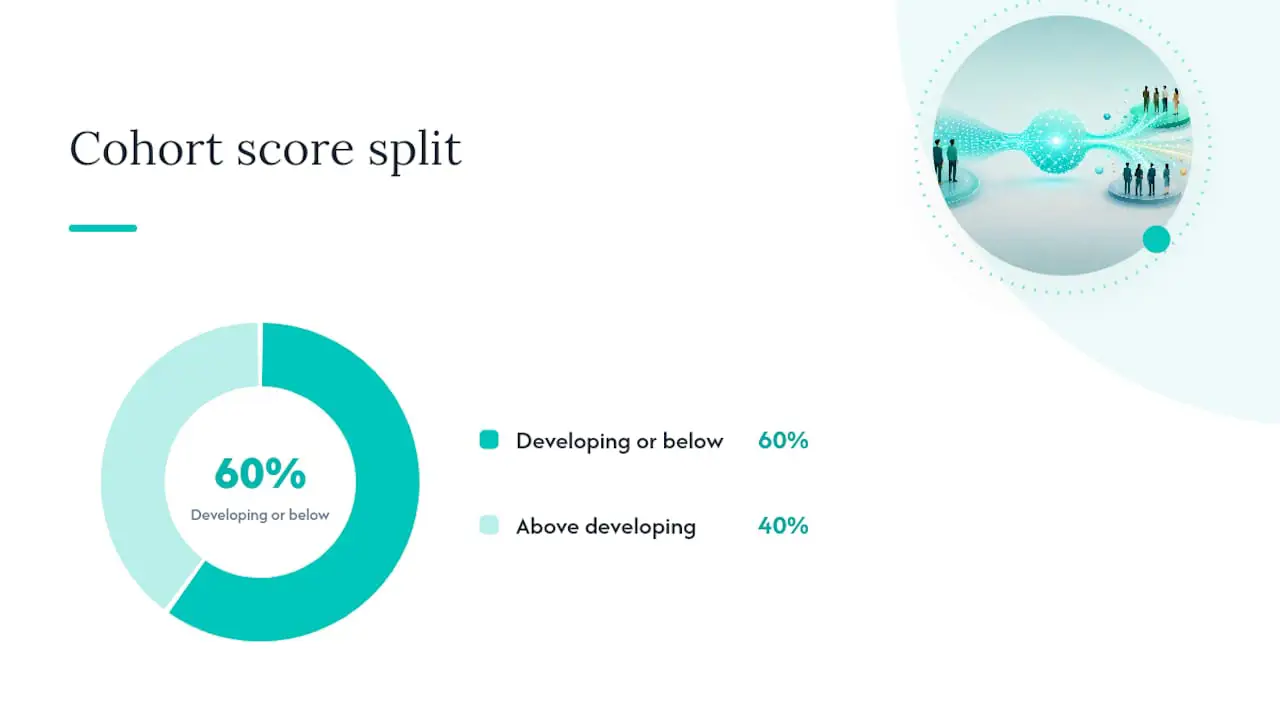
Cornells vurderingsveiledning trekker dette skillet direkte: undervisningsmessig tilbakemelding krever analytisk, kriterium-for-kriterium-detalj, mens beslutninger på programnivå krever aggregerte trender på tvers av mange studenter. Hvis 60 prosent av et avgangskull skårer «under utvikling» eller lavere på et dataanalysekriterium, er det ikke tilbakemelding til én student. Det er et signal om at læreplanen trenger en endring.
Praktiske rapporteringssteg:
- Beregn et gjennomsnitt og en distribusjon per kriterium, ikke bare et samlet gjennomsnitt.
- Marker kriterier der poengsum samler seg i den nedre enden. Det er din læreplans svake punkt.
- Dokumenter pilot- og normeringsprosessen din ved siden av resultatene. Akkrediteringsrevisorer ønsker å se at rubrikket selv ble validert, ikke bare at poengsummer eksisterer.
Normering og pålitelighet: Å holde flere sensorer konsistente
Et rubrikk er bare så pålitelig som menneskene som anvender det. To sensorer kan lese den samme deskriptoren og lande på forskjellige poengsummer med mindre de har kalibrert på forhånd.
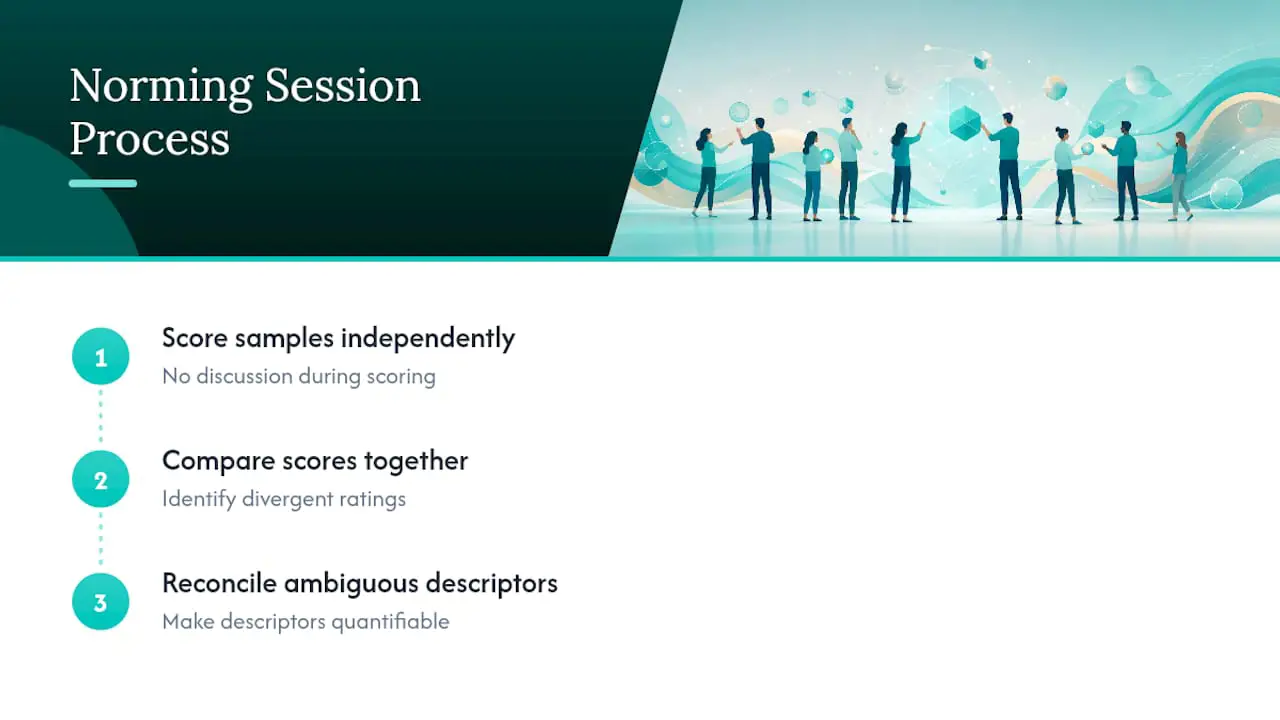
En normeringsøkt følger et klart mønster, ifølge veiledning fra UC Berkeleys GSI Teaching & Resource Center: samle en håndfull felles studenteksempler, la alle sensorer vurdere dem uavhengig uten diskusjon, og sammenlign deretter resultatene som gruppe. Der poengsummer avviker, avslører samtalen nøyaktig hvilken deskriptor som var tvetydig. Dette forsoningssteget fanger opp problemer raskere enn å bare omskrive deskriptorer i isolasjon og håpe at de leses klarere andre gang.
To deskriptorproblemer dukker stadig opp: overlappende språk mellom tilstøtende nivåer («godt» bevis kontra «sterkt» bevis, uten en målbar forskjell) og vage kvalifikatorer som betyr forskjellige ting for forskjellige lesere. Løsningen er vanligvis kvantifiserbart språk: antall kilder sitert, spesifikke feil per side, en tellbar egenskap snarere enn et adjektiv.
Pro-tips: Hvis to opplærte sensorer vurderer den samme besvarelsen mer enn ett fullt nivå fra hverandre på skalaen din, ikke legg skylden på sensoren. Skriv om deskriptoren som skiller de to nivåene først.
Beste praksis som holder rubrikker nyttige
Den største enkeltfeilen i rubrikkdesign er omfangskryp. Et rubrikk med tolv kriterier vurderer ikke mer presist; det tar bare lengre tid og inviterer til inkonsistens, fordi ingen sensor kan holde tolv distinkte standarder i hodet på én gang mens de også leser for innhold.
- Begrens kriteriene til de få som faktisk betyr noe for utfallet du måler.
- Bruk parallell deskriptorstruktur på tvers av nivåer slik at «kompetent» og «under utvikling» skiller seg etter grad, ikke etter en helt annerledes setningsstruktur.
- Gi studentene rubrikket før oppgaven er innlevert, ikke etter at karaktersettingen er begynt. Det fungerer som et veikart, ikke som et poengsummer som avsløres etter faktum.
- Bygg inn peer- eller egenvurdering ved bruk av det samme rubrikkspråket slik at studentene internaliserer kriteriene i stedet for bare å motta en dom.
- Hold hele rubrikket til én side når det er mulig. Hvis det ikke får plass, er kriterielisten sannsynligvis for lang.
Ett sammenhengende, men begrenset signal fra vurderingskontorer: å starte med et enkeltpunkts- eller meta-rubrikkformat og bare legge til kompleksitet når pilotering beviser at det er nødvendig, bidrar til å forebygge det praktikere kaller rubrikk-kryp, der et ryddig verktøy gradvis akkumulerer kriterier ingen faktisk bruker.
Hvor TalentApproved passer inn i rubrikk-basert vurdering
Alt ovenfor skalerer fint for ett enkelt klasserom. Det blir vanskeligere på tvers av et ansettelseteam som vurderer dusinvis av kandidater mot de samme kriteriene. Talent Approveds Magic Create-funksjon bygger rollespesifikke vurderinger fra en stillingsbeskrivelse eller ferdighetsliste, og kartlegger spørsmål til kriterier slik et velbygget rubrikk kartlegger kriterier til læringsutfall. KI-genererte sammendrag vurderer svar mot disse kriteriene konsekvent, mens øktavspilling og anti-juks-overvåking beskytter gyldigheten av fjernbasert testing på samme måte som normering på stedet beskytter konsistens i karaktersettingen. Relatert lesning om evalueringskriterier for kandidater dekker ansettelsessiden mer inngående.
Hva jeg har lært om å balansere rubrikkdetaljer mot karaktersettingstid
Rubrikkene som faktisk blir brukt, er ikke de mest grundige. De er de som en sensor kan anvende på under to minutter per innlevering uten å miste diagnostisk verdi – noe som vanligvis betyr å kutte kriterier du er fristet til å beholde.
Tre ting å gjøre denne uken: lag et utkast til ett rubrikk for din neste oppgave med tre til seks kriterier, pilottest det mot tre ekte eksempler før det tas i bruk, og hvis du vurderer sammen med noen andre, kjør en femten minutters normeringsøkt på to felles besvarelser.
— Jimmie
Skaler rubrikkpraksisen din med Talent Approved
Å bygge ett godt rubrikk er håndterlig. Å anvende det konsekvent på tvers av femti kandidatinnleveringer uten drift mellom vurdererne er der de fleste manuelle prosesser bryter sammen. Talent Approved er bygget for akkurat det gapet: i stedet for å håndvurdere hver respons mot kriteriene dine, gjør Magic Create en rollenbeskrivelse om til en strukturert, rubrikk-justert vurdering på få minutter, og KI-genererte sammendrag anvender scoringslogikken din på samme måte hver gang, enten det er kandidat tre eller kandidat tre hundre.
Anti-juks-overvåking og øktavspilling betyr at du kan stole på poengene du aggregerer – den samme gyldighetsbekymringen som driver normeringsøkter i et klasserom. Hvis du vil se hvordan kriteriebasert scoring oversettes fra et akademisk rubrikk til en ansettelsesarbeidsflyt, leder guiden for vurdering av T-formede ferdigheter deg gjennom å tilpasse rubrikkspråk for profesjonelle ferdighetsprofiler. Start med å utforske Talent Approved-plattformen og bygg din første vurdering fra en rollenbeskrivelse du allerede har for hånden.
Hvor du kan fordype deg i rubrikkdesign
For praktiske malbiblioteker tilbyr Utah Techs vurderingskontor og NC States undervisningsressurser begge nedlastbare eksempler på tvers av formater. Cornells Center for Teaching Innovation dekker opprettelsesprosessen i detalj, mens Northern Illinois Universitys Center for Innovative Teaching and Learning er nyttig for fagspesifikk tilpasning. For akkrediteringsklare kriterier forblir AAC&U VALUE-rubrikkene det standard referansepunktet.
Kilder
- Creating a Scoring Rubric | Academic Assessment (Utah Tech University)
- Rubrics, scoring & grading — Assessment Handbook (University of Michigan engineering)
- Using rubrics — Center for Teaching Innovation (Cornell University)
- Rubrics for Assessment — Center for Innovative Teaching and Learning (Northern Illinois University)
- Rubric best practices, examples, and templates (NCSU teaching resources)
FAQ
Hvordan lager jeg et scoringsrubrikk for en vurdering?
Tilpass rubrikket til et spesifikt læringsmål, velg 3 til 6 kriterier, sett 3 til 5 prestasjonsnivåer, skriv observerbare deskriptorer for hvert nivå, og pilottest det deretter mot ekte studentarbeid før det ferdigstilles.
Hva er scoringsrubrikker?
Scoringsrubrikker er strukturerte evalueringsverktøy som deler opp en oppgave i navngitte kriterier og beskriver hva kvalitet ser ut som på hvert prestasjonsnivå, og erstatter subjektiv karaktersetting med konsekvente standarder.
Hva er et vurderingsrubrikk?
Et vurderingsrubrikk er det samme verktøyet anvendt for å måle læringsutfall på tvers av en klasse eller et program, og aggregeres ofte for å oppdage mønstre snarere enn å vurderes utelukkende for individuell tilbakemelding.
Hva er de fire grunnleggende delene av et scoringsrubrikk?
De fire delene er oppgavebeskrivelsen, de evaluerende kriteriene, prestasjonsnivåene og deskriptorene som forklarer hva hvert prestasjonsnivå ser ut som.
Kan KI-verktøy hjelpe med å anvende rubrikker konsekvent på tvers av mange evalueringer?
Ja. Plattformer som Talent Approved bruker KI-genererte scoringssammendrag for å anvende de samme kriteriene konsekvent på tvers av store volumer av svar, noe som speiler hva normering oppnår for menneskelige sensorer.