
Byg vurderingsscorerubrikker, som undervisere kan afprøve og skalere med AI
Bedømmelsesscorerubrikker er strukturerede værktøjer, der omdanner subjektiv bedømmelse til en konsistent og forsvarlig proces. Enhver funktionel rubrik har fire dele: en opgavebeskrivelse, de kriterier du måler, præstationsniveauer der markerer kvalitetsbånd, og deskriptorer der forklarer, hvad hvert niveau faktisk ser ud til. Denne guide gennemgår, hvordan man bygger én, afprøver den på rigtige studerendes arbejde og udfører de reliabilitetstjek, der holder flere bedømmere på samme linje.
TL;DR:
- Pålidelig scoring kræver, at kriterierne begrænses til de mest virkningsfulde aspekter – typisk tre til seks – for at undgå forvirring og opretholde konsistens.
- Normeringssessioner hjælper med at kalibrere bedømmere ved at score eksempelarbejde uafhængigt og diskutere uoverensstemmelser for at præcisere fortolkningen af deskriptorer.
- At starte med målbare, observerbare deskriptorer og pilotteste en rubrik på rigtige studerendes arbejde sikrer nøjagtighed og retfærdighed i bedømmelsen.
- Brug af en enkeltpunkts-rubrik eller en meta-rubrik reducerer omfangskryb og forenkler oplæringen med henblik på konsistent anvendelse på tværs af store bedømmelsesmængder.
- AI-drevne bedømmelsesværktøjer kan reproducere rubrikkriterier konsistent i stor skala, minimere menneskelig drift og fremskynde evalueringsprocessen.
Indholdsfortegnelse
- Hvad er scorerubrikker? De fire dele, du har brug for
- Sådan opretter du en scorerubriktrin for trin
- Rubrikskabeloner du kan tilpasse i dag
- Bedømmelse af individuelle studerende vs. vurdering af programresultater
- Normering og reliabilitet: Hold flere bedømmere konsistente
- Bedste praksisser, der holder rubrikker nyttige
- Hvor TalentApproved passer ind i rubrikbaseret bedømmelse
- Hvad jeg har lært om at balancere rubrikdetaljer mod bedømmelsestid
- Skalér din rubrikpraksis med Talent Approved
- Gå dybere ned i rubrikdesign
- Kilder
- FAQ
Hvad er scorerubrikker? De fire dele, du har brug for
En scorerubriks nytteværdi afhænger udelukkende af dens struktur. Springer du én af de fire centrale dele over, glider bedømmelsen tilbage i gætteri – præcis det problem, rubrikker er skabt til at løse.
Analytiske rubrikker scorer hvert kriterium på sin egen skala og kombinerer derefter resultaterne. Hvis du bedømmer en laboratorierapport ud fra hypotesens klarhed, metodologi og dataanalyse separat, bruger du en analytisk model. Det tager længere tid at anvende, men fortæller den studerende præcist, hvor de mistede point, hvilket gør det til standardvalget for komplekse, udviklingsmæssige opgaver.
Holistiske rubrikker samler alt i én samlet score baseret på et generelt helhedsindtryk af kvaliteten. De er hurtige, hvilket er grunden til, at kurser med mange deltagere og tidsbestemte skriveprøver læner sig op ad dem, men de giver de studerende mindre at handle på, når de ønsker at forbedre sig.
Enkeltpunkts-rubrikker beskriver kun "kompetent"-niveauet i én kolonne og efterlader plads på begge sider, hvor bedømmeren kan skrive specifikke noter om, hvor arbejdet overskred eller faldt under forventningerne. De skærer forberedelsestiden ned og har ifølge vejledning fra NC States undervisningsressourcer en tendens til at producere mere individualiseret feedback end et fuldt udfyldt gitter, fordi bedømmere skriver med egne ord i stedet for at vælge en standardsætning.
Valget mellem de tre afhænger af formålet:
- Brug analytiske rubrikker til porteføljer, afsluttende projekter og enhver opgave med flere adskilte færdighedsdimensioner.
- Brug holistiske rubrikker til bedømmelse i store mængder, hvor hastighed er vigtigere end diagnostisk detalje.
- Brug enkeltpunkts-rubrikker, når du ønsker hurtig opsætning og fyldige, individuelle kommentarer.
- Start med en meta-rubrik som en AAC&U VALUE-rubrik, når du har brug for et valideret, tværinstitutionelt udgangspunkt, og indsnævr den derefter til opgavespecifikke kriterier for specialiseret arbejde som en musikjury eller et laboratoriepraksiseksamen.
Sådan opretter du en scorerubriktrin for trin
At bygge en rubrik, der faktisk holder under brug, følger en bestemt rækkefølge. Spring et trin over, og du finder ud af det under bedømmelsen – når det er dyrt at rette.
- Start med læringsmålet. Skriv en étsætnings opgavebeskrivelse, der er knyttet til, hvad studerende bør demonstrere – ikke blot hvad de bør aflevere.
- Vælg 3 til 6 kriterier. Flere end det, og bedømmerne begynder at skimme; færre og du måler reelt ikke resultatet. Hvert kriterium bør knyttes til noget, du faktisk har undervist i.
- Fastlæg 3 til 5 præstationsniveauer. Utah Techs bedømmelseskontor anbefaler at holde sig inden for det interval af hensyn til klarhed og anvendelighed; med flere niveauer end det kan bedømmere ikke pålideligt skelne mellem dem.
- Skriv observerbare deskriptorer. "Demonstrerer stærk argumentation" er vagt. "Understøtter hvert argument med mindst to stykker tekstbaseret belæg" er observerbart. Cornells Center for Teaching Innovation advarer specifikt mod ord som "interessant" eller "kreativ", fordi to bedømmere vil fortolke dem forskelligt hver gang.
- Beslut vægtning. Hvis metodologi betyder mere end formatering, sig det numerisk. En simpel aggregering kan veje fire kriterier med 30/30/25/15 procent i stedet for at fordele det ligeligt.
- Pilottest på rigtige studerendes arbejde og revider. Cornells vejledning peger på at teste et udkast mod faktiske afleveringer, inden det færdiggøres, og praktikere, der gør dette regelmæssigt, oplever, at scoring af tre til ti eksempelopgaver normalt er nok til at afsløre, hvor en deskriptor ikke formår at skelne mellem to tilstødende niveauer.
Professionelt tip: Bedøm en stak på fem opgaver med dit rubrikudkast, inden du rører ved en eneste rigtig karakter. Hvis du ikke konsistent kan forklare, hvorfor en opgave landede i "kompetent" frem for "under udvikling", er det deskriptoren, der er problemet – ikke den studerendes arbejde.
Rubrikskabeloner du kan tilpasse i dag
Skabeloner sparer tid, men kun hvis du tilpasser sproget til din disciplin i stedet for at kopiere det fuldstændigt.
En kompakt analytisk rubrik til et kort essay kan score Tese-klarhed, Brug af belæg og Struktur på tværs af fire niveauer: Fremragende, Kompetent, Under udvikling og Begyndende. Vægt hvert kriterium ligeligt til at starte med, og justér derefter, når du ser, hvor studerende faktisk kæmper. En samlet score på 12/12 bliver meningsfuld, når deskriptorerne under hvert niveau er tilstrækkeligt specifikke til, at en kollega, der bedømmer uden at kende baggrunden, ville lande på det samme tal.
En holistisk rubrik fungerer godt til en tidsbestemt respons i klassen. I stedet for separate kriterier skriver du fire eller fem afsnit med benchmark-beskrivelser – ét per scoreband – og matcher den studerendes arbejde med den tættest liggende overordnede beskrivelse. Nogle programmer fremskynder dette yderligere med en "stak"-metode: sortér ubedømte opgaver i grove bunker først, og tildel derefter tal inden for hver bunke.
En enkeltpunktsskabelon lister dine kriterier ned langs venstre side med kun kolonnen "opfylder forventningerne" udfyldt. Lad kolonnerne "under" og "over" stå tomme til håndskrevne noter:
- Kriteriekolonne: navngiv færdigheden (tese, belæg, sproglig korrekthed).
- Kolonne for opfylder forventningerne: én klar sætning, der beskriver solidt arbejde.
- Kolonner for bekymringer/styrker: tomt felt til målrettede kommentarer.
At tilpasse nogen af disse på tværs af discipliner handler for det meste om at udskifte ordforrådet. En rubrik til laboratoriepraksiseksamen erstatter "tese-klarhed" med "hypotesesformulering", mens en præsentationsrubrik tilføjer et kriterium for vokal fremføring, som en rubrik til skriftlige essays aldrig ville have brug for.
Bedømmelse af individuelle studerende vs. vurdering af programresultater
En rubrikscore betyder noget forskelligt afhængigt af, hvem der læser den. Når du bedømmer, tilhører tallet én studerende og skaber feedback på dennes specifikke arbejde. Når du foretager resultatevaluering, aggregeres de samme rubrikdata på tværs af en hel klasse eller et helt program, og den enkelte forsvinder ind i et mønster.
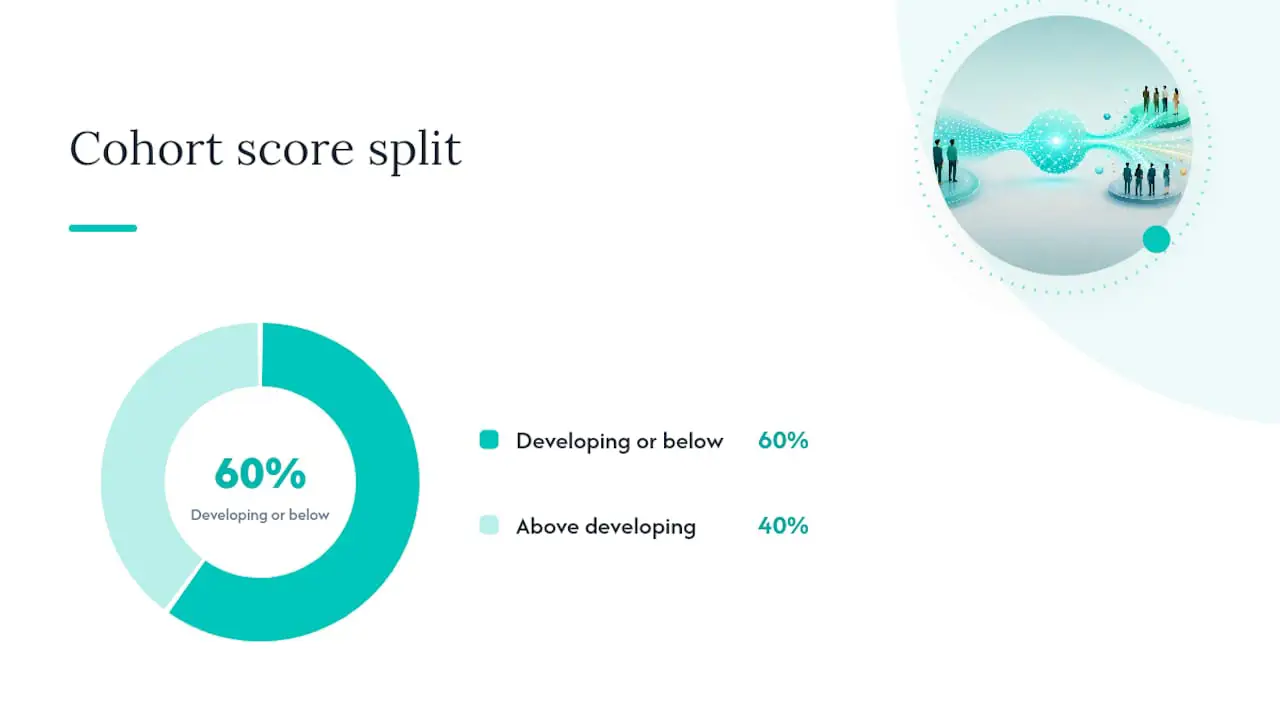
Cornells bedømmesesvejledning drager denne sondring direkte: undervisningsfeedback kræver analytisk, kriteriefor-kriterium-detalje, mens beslutninger på programniveau kræver aggregerede tendenser på tværs af mange studerende. Hvis 60 procent af en afgangsårgang scorer "under udvikling" eller lavere på et dataanalysekriterium, er det ikke feedback til én studerende. Det er et signal om, at læseplanen har brug for en ændring.
Praktiske rapporteringstrin:
- Beregn et gennemsnit og en fordeling per kriterium – ikke kun et samlet gennemsnit.
- Markér kriterier, hvor scorer klumper sig i den lave ende. Det er dit svage punkt i læseplanen.
- Dokumentér din pilot- og normeringsproces sammen med resultaterne. Akkrediteringsreviewere ønsker at se, at selve rubrikken blev valideret – ikke kun at der eksisterer scorer.
Normering og reliabilitet: Hold flere bedømmere konsistente
En rubrik er kun så pålidelig som de mennesker, der anvender den. To bedømmere kan læse den samme deskriptor og lande på forskellige scorer, medmindre de har kalibreret sig først.
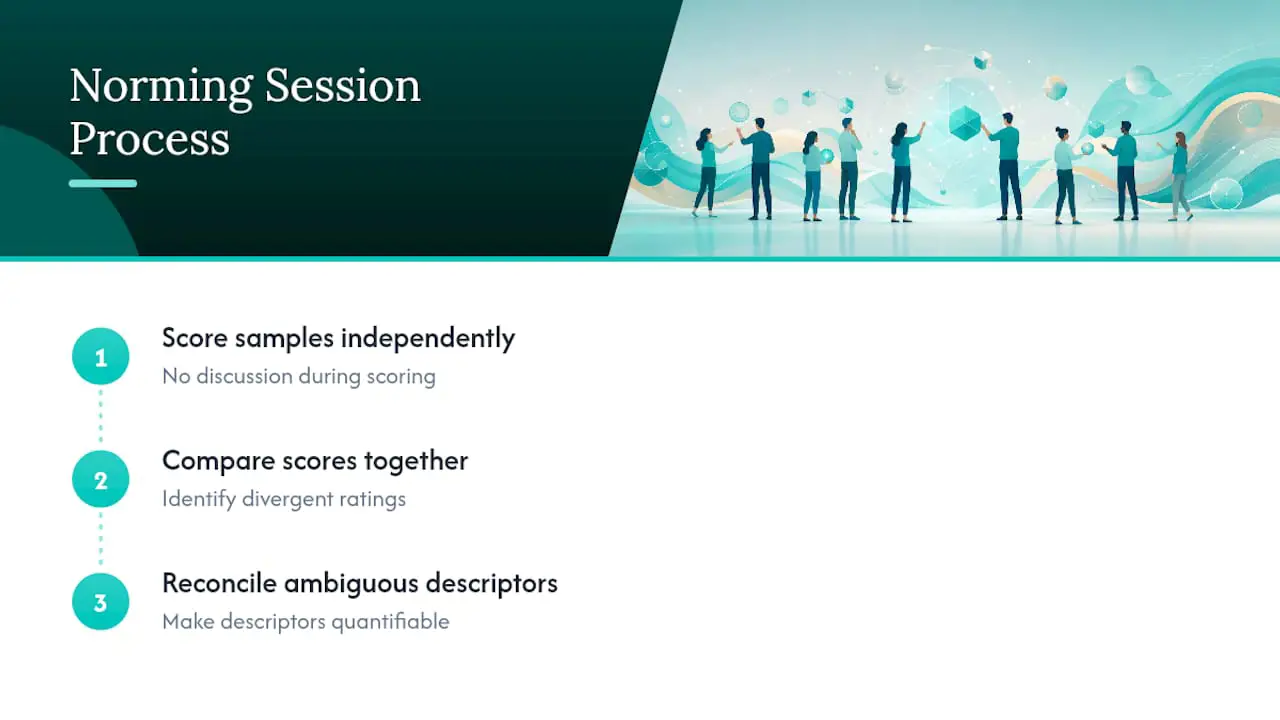
En normeringssession følger et klart mønster ifølge vejledning fra UC Berkeleys GSI Teaching & Resource Center: saml en håndfuld fælles studenteeksempler, lad alle bedømmere score dem uafhængigt uden diskussion, og sammenlign derefter resultaterne som gruppe. Overalt, hvor scorer afviger, afslører samtalen præcis hvilken deskriptor der var uklar. Dette forsoningsstep afdækker problemer hurtigere end blot at omskrive deskriptorer isoleret og håbe, at de læses tydeligere anden gang.
To deskriptorproblemer dukker hele tiden op: overlappende sprog mellem tilstødende niveauer ("godt" belæg versus "stærkt" belæg uden en målbar forskel) og vage kvalifikatorer, der betyder noget forskelligt for forskellige læsere. Løsningen er som regel kvantificerbart sprog: antal citerede kilder, specifikke fejl per side, en tællelbar egenskab frem for et tillægsord.
Professionelt tip: Hvis to trænede bedømmere scorer den samme opgave mere end ét fuldt niveau fra hinanden på din skala, skal du ikke bebrejde bedømmeren. Omskriv deskriptoren, der adskiller de to niveauer, først.
Bedste praksisser, der holder rubrikker nyttige
Den største enkeltfejl i rubrikdesign er omfangskryb. En rubrik med tolv kriterier bedømmer ikke mere præcist; den tager blot længere tid og inviterer til inkonsistens, fordi ingen bedømmer kan holde tolv adskilte standarder i hovedet på én gang, mens de også læser for indhold.
- Begræns kriterierne til de få, der faktisk betyder noget for det resultat, du måler.
- Brug parallel deskriptorstruktur på tværs af niveauer, så "kompetent" og "under udvikling" adskiller sig efter grad – ikke ved en helt anden sætningsstruktur.
- Giv de studerende rubrikken, inden opgaven afleveres – ikke efter bedømmelsen er begyndt. Den fungerer som en vejledning, ikke et scorekort afsløret i efterhånd.
- Byg peer- eller selvvurdering ind ved hjælp af samme rubriksprog, så de studerende internaliserer kriterierne frem for blot at modtage en dom.
- Hold hele rubrikken til én side, når det er muligt. Passer den ikke, er kriterielisten sandsynligvis for lang.
Ét sammenhængende, men begrænset signal fra bedømmelseskontorer: at starte med et enkeltpunkts- eller meta-rubrikformat og kun tilføje kompleksitet, når pilottestning beviser, at det er nødvendigt, hjælper med at forhindre det, praktikere kalder rubrik-kryb – hvor et rent værktøj langsomt akkumulerer kriterier, som ingen faktisk bruger.
Hvor Talent Approved passer ind i rubrikbaseret bedømmelse
Alt ovenstående skalerer fint i et enkelt klasserum. Det bliver sværere på tværs af et ansættelsesteam, der scorer snesevis af kandidater ud fra de samme kriterier. Talent Approveds Magic Create-funktion bygger rollespecifikke bedømmelser ud fra en jobbeskrivelse eller en liste over færdigheder og knytter spørgsmål til kriterier på samme måde, som en velbygget rubrik knytter kriterier til læringsmål. AI-genererede resuméer scorer svar mod disse kriterier konsistent, mens sessionafspilning og anti-snydeovervågning beskytter validiteten af fjerntest på samme måde, som normeringssessioner på stedet beskytter bedømmelseskonsistensen. Relateret læsning om evalueringskriterier for kandidater dækker ansættelsessperspektivet mere dybdegående.
Hvad jeg har lært om at balancere rubrikdetaljer mod bedømmelsestid
De rubrikker, der faktisk bliver brugt, er ikke de mest grundige. De er dem, en bedømmer kan anvende på under to minutter per aflevering uden at miste diagnostisk værdi – hvilket normalt betyder at skære kriterier væk, man er fristet til at beholde.
Tre ting at gøre denne uge: udkast til én rubrik til din næste opgave med tre til seks kriterier, pilottest den mod tre rigtige eksempler, inden den går i brug, og hvis du bedømmer sammen med andre, afhold en femten minutters normeringssession på to fælles opgaver.
— Jimmie
Skalér din rubrikpraksis med Talent Approved
At bygge én god rubrik er overkommeligt. At anvende den konsistent på tværs af halvtreds kandidatbesvarelser uden nogen drift mellem bedømmere er dér, de fleste manuelle processer bryder sammen. Talent Approved er bygget til præcis dette hul: i stedet for at håndscorer hvert svar mod dine kriterier, omdanner Magic Create en rollebeskrivelse til en struktureret, rubrikafstemmetbedømmelse på få minutter, og AI-genererede resuméer anvender din scoringslogik på samme måde hver gang – uanset om det er kandidat tre eller kandidat tre hundrede.
Anti-snydeovervågning og sessionafspilning betyder, at du kan stole på de scorer, du aggregerer – den samme valideringsbekymring, der driver normeringssessioner i et klasserum. Hvis du vil se, hvordan kriteriebaseret scoring oversættes fra en akademisk rubrik til en ansættelsesworkflow, gennemgår vejledningen til T-formede færdighedsvurderinger tilpasning af rubriksprog til professionelle færdighedsprofiler. Start med at udforske Talent Approved-platformen og byg din første bedømmelse ud fra en rollebeskrivelse, du allerede har ved hånden.
Gå dybere ned i rubrikdesign
Til hands-on skabelonbiblioteker tilbyder Utah Techs bedømmelseskontor og NC States undervisningsressourcer begge downloadbare eksempler på tværs af formater. Cornells Center for Teaching Innovation dækker oprettelsesprocessen i detaljer, mens Northern Illinois Universitys Center for Innovative Teaching and Learning er nyttigt til disciplinspecifik tilpasning. For akkrediteringsklar kriterier forbliver AAC&U VALUE-rubrikkerne det standardiserede referencepunkt.
Kilder
- Creating a Scoring Rubric | Academic Assessment (Utah Tech University)
- Rubrics, scoring & grading — Assessment Handbook (University of Michigan engineering)
- Using rubrics — Center for Teaching Innovation (Cornell University)
- Rubrics for Assessment — Center for Innovative Teaching and Learning (Northern Illinois University)
- Rubric best practices, examples, and templates (NCSU teaching resources)
FAQ
Hvordan opretter jeg en scorerubriktil en bedømmelse?
Tilpas rubrikken til et specifikt læringsmål, vælg 3 til 6 kriterier, fastlæg 3 til 5 præstationsniveauer, skriv observerbare deskriptorer for hvert niveau, og pilottest den derefter mod rigtige studerendes arbejde, inden den færdiggøres.
Hvad er scorerubrikker?
Scorerubrikker er strukturerede evalueringsværktøjer, der opdeler en opgave i navngivne kriterier og beskriver, hvordan kvalitet ser ud på hvert præstationsniveau – og erstatter subjektiv bedømmelse med konsistente standarder.
Hvad er en bedømmelsesrubrik?
En bedømmelsesrubrik er det samme værktøj anvendt til at måle læringsresultater på tværs af en klasse eller et program, ofte aggregeret for at identificere mønstre frem for udelukkende at score til individuel feedback.
Hvad er de fire grundlæggende dele af en scorerubriks?
De fire dele er opgavebeskrivelsen, de evaluerende kriterier, præstationsniveauerne og deskriptorerne, der forklarer, hvad hvert præstationsniveau ser ud til.
Kan AI-værktøjer hjælpe med at anvende rubrikker konsistent på tværs af mange evalueringer?
Ja. Platforme som Talent Approved bruger AI-genererede scoringsresumeer til at anvende de samme kriterier konsistent på tværs af store mængder besvarelser, hvilket spejler det, normering opnår for menneskelige bedømmere.