
Создайте рубрики оценивания, которые педагоги могут пилотировать и масштабировать с помощью ИИ
Рубрики для оценивания — это структурированные инструменты, которые превращают субъективную проверку работ в последовательный и обоснованный процесс. Каждая работающая рубрика состоит из четырёх частей: описание задания, критерии оценивания, уровни успешности, обозначающие диапазоны качества, и дескрипторы, объясняющие, как выглядит каждый уровень на практике. В этом руководстве рассказывается, как создать рубрику, проверить её на реальных студенческих работах и провести проверку надёжности, позволяющую нескольким проверяющим оставаться на одной волне.
Коротко о главном:
- Надёжное оценивание требует ограничения числа критериев наиболее значимыми аспектами — как правило, от трёх до шести, — чтобы избежать путаницы и обеспечить последовательность.
- Сессии нормирования помогают откалибровать проверяющих: они оценивают образцы работ независимо, а затем обсуждают расхождения, чтобы уточнить интерпретацию дескрипторов.
- Начало работы с измеримыми, наблюдаемыми дескрипторами и пилотное тестирование рубрики на реальных студенческих работах обеспечивают точность и справедливость оценивания.
- Использование одноточечной рубрики или мета-рубрики снижает расширение охвата и упрощает обучение для последовательного применения при больших объёмах оценивания.
- Инструменты оценивания на основе искусственного интеллекта могут последовательно воспроизводить критерии рубрики в масштабе, минимизируя отклонения, вносимые людьми, и ускоряя процесс оценки.
Содержание
- Что такое рубрики для оценивания? Четыре необходимые части
- Как создать рубрику для оценивания: пошаговое руководство
- Шаблоны рубрик, которые можно адаптировать уже сегодня
- Оценка отдельных студентов и оценка результатов программы
- Нормирование и надёжность: согласованность нескольких проверяющих
- Лучшие практики, сохраняющие рубрики полезными
- Место TalentApproved в оценивании на основе рубрик
- Чему я научился, балансируя детализацию рубрики и время проверки
- Масштабируйте работу с рубриками с помощью Talent Approved
- Где узнать больше о разработке рубрик
- Источники
- FAQ
Что такое рубрики для оценивания? Четыре необходимые части
Рубрика для оценивания полезна ровно настолько, насколько продумана её структура. Пропустите одну из четырёх ключевых частей — и оценивание снова превратится в угадывание, а именно эту проблему рубрики и призваны решить.
Аналитические рубрики оценивают каждый критерий по собственной шкале, а затем объединяют результаты. Если вы оцениваете лабораторный отчёт отдельно по чёткости гипотезы, методологии и анализу данных, вы используете аналитическую модель. Её применение занимает больше времени, но позволяет студенту точно понять, за что были сняты баллы, что делает её стандартным выбором для сложных, многоэтапных заданий.
Холистические рубрики сводят всё к единой итоговой оценке, основанной на общем впечатлении о качестве работы. Они быстры в применении — именно поэтому на них опираются большие курсы с высокой посещаемостью и письменные работы с ограничением по времени, — однако дают студентам меньше конкретных ориентиров для улучшения.
Одноточечные рубрики описывают только уровень «компетентно» в одном столбце, оставляя место по обе стороны для записи проверяющим конкретных замечаний о том, где работа превзошла ожидания или не дотянула до них. Они сокращают время подготовки и, согласно рекомендациям учебных ресурсов NC State, как правило, дают более индивидуализированную обратную связь, чем полностью заполненная сетка, поскольку проверяющие пишут своими словами, а не выбирают готовую фразу.
Выбор одного из трёх вариантов определяется целью:
- Используйте аналитические рубрики для портфолио, итоговых проектов и любых заданий с несколькими самостоятельными аспектами навыков.
- Используйте холистические рубрики при больших объёмах проверки, где скорость важнее диагностической детализации.
- Используйте одноточечные рубрики, когда вам нужна быстрая настройка и содержательные индивидуальные комментарии.
- Начинайте с мета-рубрики, например рубрики AAC&U VALUE, когда нужна проверенная отправная точка для нескольких организаций, а затем сужайте её до специфических критериев конкретного задания — например, музыкального экзамена или лабораторного практикума.
Как создать рубрику для оценивания: пошаговое руководство
Создание рубрики, которая действительно выдержит проверку на практике, требует соблюдения определённой последовательности. Пропустите шаг — и вы обнаружите это в процессе проверки работ, когда исправлять ошибки уже дорого.
- Начните с образовательного результата. Составьте одно предложение с описанием задания, привязанного к тому, что студенты должны продемонстрировать, а не просто сдать.
- Выберите от 3 до 6 критериев. Больше — и проверяющие начнут просматривать поверхностно; меньше — и вы по-настоящему не измеряете результат. Каждый критерий должен соответствовать тому, чему вы действительно обучали.
- Установите от 3 до 5 уровней успешности. Отдел оценивания Utah Tech рекомендует придерживаться этого диапазона ради ясности и удобства использования: при большем числе уровней оценщики не смогут надёжно их различить.
- Пишите наблюдаемые дескрипторы. «Демонстрирует убедительную аргументацию» — расплывчато. «Подкрепляет каждый тезис как минимум двумя фрагментами текстовых доказательств» — наблюдаемо. Центр инновационного обучения Cornell специально предостерегает от таких слов, как «интересный» или «творческий», поскольку два проверяющих будут интерпретировать их по-разному каждый раз.
- Определите веса критериев. Если методология важнее оформления — выразите это числово. При простом суммировании можно, например, назначить четырём критериям веса 30/30/25/15 процентов вместо равномерного распределения.
- Проведите пилотное тестирование на реальных студенческих работах и пересмотрите рубрику. Рекомендации Cornell указывают на необходимость проверки черновика на реальных работах перед его утверждением; практики, которые регулярно это делают, обнаруживают, что проверки от трёх до десяти образцов работ, как правило, достаточно, чтобы выявить, где дескриптор не позволяет разграничить два соседних уровня.
Совет профессионала: Проверьте стопку из пяти работ по черновой рубрике, прежде чем выставлять хоть одну настоящую оценку. Если вы не можете последовательно объяснить, почему работа попала в категорию «компетентно», а не «в процессе развития», — проблема в дескрипторе, а не в работе студента.
Шаблоны рубрик, которые можно адаптировать уже сегодня
Шаблоны экономят время, но только если вы адаптируете язык к своей дисциплине, а не копируете его целиком.
Компактная аналитическая рубрика для короткого эссе может оценивать чёткость тезиса, использование доказательств и структуру по четырём уровням: «Образцово», «Компетентно», «В процессе развития» и «Начальный уровень». Для начала назначьте каждому критерию одинаковый вес, а затем скорректируйте его, увидев, с чем студенты на самом деле испытывают трудности. Итоговый балл 12/12 становится значимым, как только дескрипторы под каждым уровнем достаточно конкретны, чтобы коллега, проверяющий вслепую, пришёл к тому же результату.
Холистическая рубрика хорошо подходит для аудиторных работ с ограниченным временем. Вместо отдельных критериев напишите четыре-пять эталонных описаний уровня абзацем — по одному на каждый диапазон баллов — и соотнесите работу студента с наиболее подходящим общим описанием. Некоторые программы ещё больше ускоряют этот процесс с помощью метода «стопок»: сначала сортируют непроверенные работы на примерные кучки, а затем присваивают баллы внутри каждой кучки.
Одноточечный шаблон перечисляет критерии слева, при этом заполнен только столбец «соответствует ожиданиям». Столбцы «ниже» и «выше» оставьте пустыми для рукописных заметок:
- Столбец «Критерии»: название навыка (тезис, доказательства, грамотность).
- Столбец «Соответствует ожиданиям»: одно чёткое предложение, описывающее качественную работу.
- Столбцы «Замечания / достоинства»: свободное место для конкретных комментариев.
Адаптация любого из этих шаблонов для разных дисциплин в основном сводится к замене терминологии. В рубрике для лабораторного практикума «чёткость тезиса» заменяется «формулировкой гипотезы», а в рубрике для презентации добавляется критерий качества речи, который в рубрике для письменного эссе никогда не понадобится.
Оценка отдельных студентов и оценка результатов программы
Балл по рубрике означает разное в зависимости от того, кто его читает. Когда вы выставляете оценку, число принадлежит одному студенту и направляет обратную связь по его конкретной работе. Когда вы проводите оценку результатов, те же данные рубрики агрегируются по всему курсу или программе, и отдельный человек растворяется в закономерности.
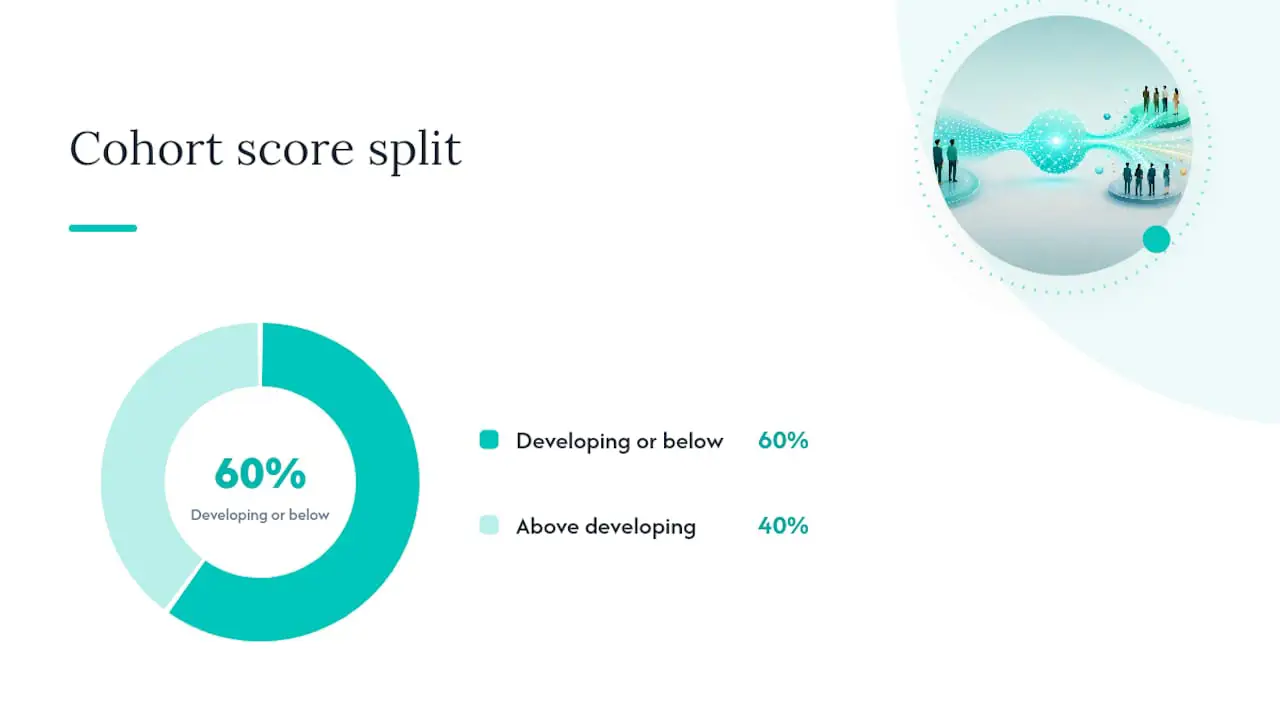
Рекомендации Cornell по оцениванию прямо проводят это различие: учебная обратная связь требует аналитической детализации по каждому критерию, тогда как решения на уровне программы требуют агрегированных тенденций по большому числу студентов. Если 60 процентов выпускного потока получает оценку «в процессе развития» или ниже по критерию анализа данных — это не обратная связь для одного студента. Это сигнал о необходимости изменений в учебной программе.
Практические шаги по составлению отчётности:
- Вычислите среднее значение и распределение по каждому критерию, а не только общее среднее.
- Отметьте критерии, где оценки концентрируются в нижней части. Это слабое место вашей учебной программы.
- Задокументируйте процесс пилотирования и нормирования вместе с результатами. Рецензенты по аккредитации хотят убедиться, что сама рубрика была валидирована, а не просто что существуют какие-то баллы.
Нормирование и надёжность: согласованность нескольких проверяющих
Рубрика надёжна ровно настолько, насколько надёжны применяющие её люди. Два проверяющих могут прочитать один и тот же дескриптор и прийти к разным оценкам, если они предварительно не откалибровались.
Сессия нормирования следует чёткой схеме, согласно рекомендациям Учебного и ресурсного центра GSI Калифорнийского университета в Беркли: соберите несколько общих образцов студенческих работ, попросите каждого проверяющего оценить их самостоятельно без обсуждения, а затем сравните результаты в группе. Там, где оценки расходятся, разговор покажет, какой именно дескриптор оказался неоднозначным. Этот этап согласования выявляет проблемы быстрее, чем простое переписывание дескрипторов в одиночку в надежде, что они окажутся понятнее с повторной попытки.
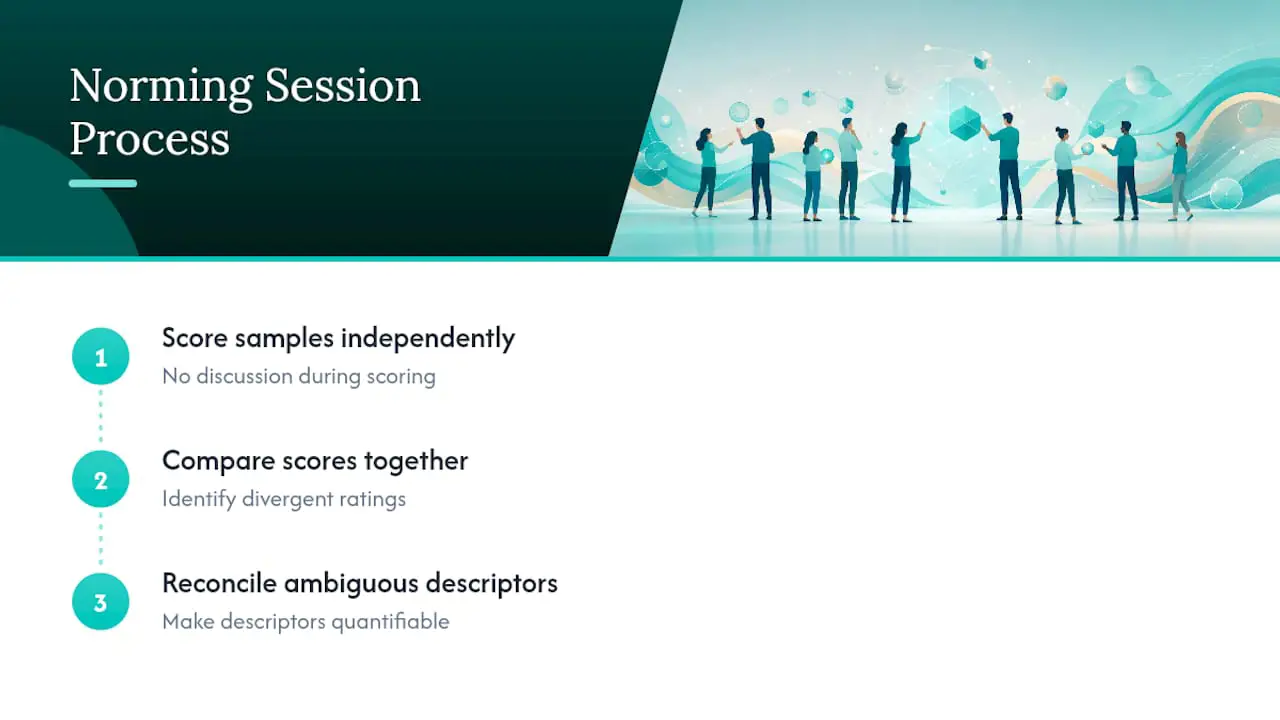
Постоянно встречаются две проблемы с дескрипторами: пересекающиеся формулировки соседних уровней («хорошие» доказательства против «убедительных» без измеримого различия) и расплывчатые определения, которые разные читатели трактуют по-разному. Решение, как правило, состоит в переходе к количественным формулировкам: число процитированных источников, конкретное количество ошибок на страницу, поддающийся подсчёту признак вместо прилагательного.
Совет профессионала: Если два обученных проверяющих оценивают одну работу с разницей более чем в один полный уровень по вашей шкале — не вините проверяющего. Сначала перепишите дескриптор, разграничивающий эти два уровня.
Лучшие практики, сохраняющие рубрики полезными
Главный способ испортить рубрику — это расширение охвата. Рубрика с двенадцатью критериями не делает оценку точнее; она лишь занимает больше времени и провоцирует непоследовательность, поскольку ни один проверяющий не в состоянии одновременно удерживать в голове двенадцать отдельных стандартов, ещё и читая работу по содержанию.
- Ограничьте критерии теми немногими, которые действительно важны для измеряемого результата.
- Используйте параллельную структуру дескрипторов на всех уровнях, чтобы «компетентно» и «в процессе развития» различались по степени, а не по совершенно иной структуре предложения.
- Выдавайте рубрику студентам до сдачи задания, а не после начала проверки. Она служит дорожной картой, а не табло, открываемым постфактум.
- Включите взаимооценку или самооценку с использованием того же языка рубрики, чтобы студенты усвоили критерии, а не просто получили вердикт.
- По возможности умещайте всю рубрику на одной странице. Если не вмещается — список критериев, вероятно, слишком длинный.
Один последовательный, но ограниченный сигнал от отделов оценивания: начало с одноточечного формата или мета-рубрики с добавлением сложности только тогда, когда пилотирование доказывает её необходимость, помогает предотвратить то, что практики называют «расползанием рубрики» — постепенным накоплением критериев, которыми на деле никто не пользуется.
Место Talent Approved в оценивании на основе рубрик
Всё вышесказанное прекрасно масштабируется в рамках одного класса. Сложнее становится, когда команда рекрутеров оценивает десятки кандидатов по одним и тем же критериям. Функция Magic Create в Talent Approved создаёт задания под конкретную роль на основе описания вакансии или перечня навыков, сопоставляя вопросы с критериями так же, как хорошо составленная рубрика сопоставляет критерии с образовательными результатами. Итоговые резюме, генерируемые ИИ, последовательно оценивают ответы по этим критериям, а мониторинг сессий и защита от списывания обеспечивают достоверность дистанционного тестирования так же, как очные сессии нормирования обеспечивают согласованность проверки. Дополнительные материалы о критериях оценки кандидатов подробнее освещают применение на стороне найма.
Чему я научился, балансируя детализацию рубрики и время проверки
Рубрики, которые реально используются, — это не самые подробные из них. Это те, которые проверяющий может применить менее чем за две минуты на работу, не теряя диагностической ценности, — а это обычно означает исключение критериев, которые так хочется оставить.
Три вещи, которые стоит сделать на этой неделе: составьте одну рубрику для следующего задания с тремя-шестью критериями, проверьте её на трёх реальных работах до запуска в дело, и если вы проверяете работы вместе с кем-то ещё — проведите пятнадцатиминутную сессию нормирования на двух общих работах.
— Jimmie
Масштабируйте работу с рубриками с помощью Talent Approved
Создать одну хорошую рубрику вполне реально. Применять её последовательно к пятидесяти заявкам кандидатов без малейших отклонений между проверяющими — вот где большинство ручных процессов ломаются. Talent Approved создан именно для того, чтобы заполнить этот пробел: вместо ручной проверки каждого ответа по вашим критериям Magic Create превращает описание роли в структурированное, выровненное по рубрике задание за считаные минуты, а итоговые резюме на основе ИИ применяют вашу логику оценивания одинаково каждый раз — будь то третий кандидат или трёхсотый.
Мониторинг защиты от списывания и воспроизведение сессий означают, что агрегируемым оценкам можно доверять — та же проблема достоверности, которая лежит в основе сессий нормирования в аудитории. Если вы хотите увидеть, как критериальное оценивание переходит от академической рубрики к рабочему процессу найма, руководство по оценке T-образных навыков рассказывает об адаптации языка рубрики для профессиональных профилей навыков. Начните с изучения платформы Talent Approved и создайте своё первое задание на основе уже имеющегося у вас описания роли.
Где узнать больше о разработке рубрик
Для библиотек практических шаблонов отдел оценивания Utah Tech и учебные ресурсы NC State предлагают загружаемые примеры в разных форматах. Центр инновационного обучения Cornell подробно освещает процесс создания рубрик, а Центр инновационного преподавания и обучения Северного университета Иллинойса полезен для адаптации под конкретные дисциплины. Для критериев, пригодных для аккредитации, рубрики AAC&U VALUE по-прежнему остаются стандартным источником.
Источники
- Creating a Scoring Rubric | Academic Assessment (Utah Tech University)
- Rubrics, scoring & grading — Assessment Handbook (University of Michigan engineering)
- Using rubrics — Center for Teaching Innovation (Cornell University)
- Rubrics for Assessment — Center for Innovative Teaching and Learning (Northern Illinois University)
- Rubric best practices, examples, and templates (NCSU teaching resources)
FAQ
Как создать рубрику для оценивания?
Привяжите рубрику к конкретному образовательному результату, выберите от 3 до 6 критериев, установите от 3 до 5 уровней успешности, напишите наблюдаемые дескрипторы для каждого уровня, а затем проверьте её на реальных студенческих работах перед окончательным утверждением.
Что такое рубрики для оценивания?
Рубрики для оценивания — это структурированные инструменты оценки, которые разбивают задание на именованные критерии и описывают, как выглядит качество на каждом уровне успешности, заменяя субъективную проверку последовательными стандартами.
Что такое оценочная рубрика?
Оценочная рубрика — это тот же инструмент, применяемый для измерения образовательных результатов в рамках курса или программы; данные по ней часто агрегируются для выявления закономерностей, а не используются исключительно для индивидуальной обратной связи.
Каковы четыре основные части рубрики для оценивания?
Четыре части — это описание задания, критерии оценивания, уровни успешности и дескрипторы, объясняющие, как выглядит каждый уровень успешности.
Могут ли инструменты ИИ помочь последовательно применять рубрики при большом объёме оценивания?
Да. Платформы вроде Talent Approved используют итоговые резюме, генерируемые ИИ, для последовательного применения одних и тех же критериев к большому числу ответов — это аналог того, чего сессии нормирования позволяют достичь для проверяющих-людей.