
AI کے ساتھ تشخیصی اسکورنگ روبرکس بنائیں جو معلمین پائلٹ اور اسکیل کر سکیں
تشخیصی اسکورنگ روبرکس ایسے منظم آلات ہیں جو ساپیکش گریڈنگ کو ایک مستقل اور قابلِ دفاع عمل میں تبدیل کر دیتے ہیں۔ ہر کارآمد روبرک کے چار حصے ہوتے ہیں: کام کی تفصیل، وہ معیار جنہیں آپ پیمائش کر رہے ہیں، کارکردگی کی سطحیں جو معیار کی حدود کو ظاہر کرتی ہیں، اور تفصیلات جو بتاتی ہیں کہ ہر سطح دراصل کیسی نظر آتی ہے۔ یہ گائیڈ ایک روبرک بنانے، اسے حقیقی طلبہ کے کام پر آزمانے، اور قابلِ اعتماد جانچ چلانے کے عمل کی رہنمائی کرتی ہے تاکہ متعدد گریڈ دینے والے ایک ہی صفحے پر رہیں۔
TL;DR:
- قابلِ اعتماد اسکورنگ کے لیے معیار کو سب سے زیادہ اثرانگیز پہلوؤں تک محدود رکھنا ضروری ہے، عام طور پر تین سے چھ تک، تاکہ الجھن سے بچا جا سکے اور مستقل مزاجی برقرار رہے۔
- نورمنگ سیشنز گریڈرز کو کیلیبریٹ کرنے میں مدد دیتے ہیں، جس میں نمونہ کام کو آزادانہ طور پر اسکور کیا جاتا ہے اور تفصیلات کی تشریح کو واضح کرنے کے لیے اختلافات پر بحث کی جاتی ہے۔
- قابلِ پیمائش اور قابلِ مشاہدہ تفصیلات سے شروع کرنا اور حقیقی طلبہ کے کام پر روبرک کی آزمائشی جانچ کرنا گریڈنگ کی درستگی اور انصاف پسندی کو یقینی بناتا ہے۔
- سنگل پوائنٹ روبرک یا میٹا-روبرک کا استعمال دائرے کے پھیلاؤ کو کم کرتا ہے اور بڑی تعداد میں تشخیص کے دوران مستقل اطلاق کے لیے تربیت کو آسان بناتا ہے۔
- AI سے چلنے والے تشخیصی آلات روبرک کے معیار کو بڑے پیمانے پر مستقل طریقے سے نقل کر سکتے ہیں، جس سے انسانی انحراف کم ہوتا ہے اور تشخیص کا عمل تیز ہو جاتا ہے۔
فہرستِ مضامین
- اسکورنگ روبرکس کیا ہیں؟ وہ چار حصے جن کی آپ کو ضرورت ہے
- اسکورنگ روبرک بنانے کا طریقہ: قدم بہ قدم
- روبرک ٹیمپلیٹس جنہیں آپ آج اپنا سکتے ہیں
- انفرادی طلبہ کی گریڈنگ بمقابلہ پروگرام کے نتائج کی تشخیص
- نورمنگ اور قابلِ اعتماد: متعدد گریڈرز کو مستقل رکھنا
- بہترین طریقے جو روبرکس کو مفید رکھتے ہیں
- Talent Approved روبرک پر مبنی تشخیص میں کہاں فٹ بیٹھتا ہے
- میں نے روبرک کی تفصیل اور گریڈنگ کے وقت کے درمیان توازن کے بارے میں کیا سیکھا
- Talent Approved کے ساتھ اپنی روبرک پریکٹس کو وسعت دیں
- روبرک ڈیزائن پر مزید گہرائی میں کہاں جائیں
- ماخذ
- اکثر پوچھے جانے والے سوالات
اسکورنگ روبرکس کیا ہیں؟ وہ چار حصے جن کی آپ کو ضرورت ہے
ایک اسکورنگ روبرک اتنا ہی مفید ہوتا ہے جتنا اس کا ڈھانچہ۔ چار بنیادی حصوں میں سے ایک چھوڑ دیں تو گریڈنگ دوبارہ قیاس آرائی میں تبدیل ہو جاتی ہے، جو کہ وہی مسئلہ ہے جسے حل کرنے کے لیے روبرکس موجود ہیں۔
تجزیاتی روبرکس ہر معیار کو اپنے پیمانے پر اسکور کرتے ہیں، پھر نتائج کو یکجا کرتے ہیں۔ اگر آپ لیب رپورٹ کو مفروضے کی وضاحت، طریقہ کار، اور ڈیٹا تجزیے پر الگ الگ گریڈ دے رہے ہیں، تو آپ تجزیاتی ماڈل استعمال کر رہے ہیں۔ اسے لاگو کرنے میں زیادہ وقت لگتا ہے لیکن یہ طالب علم کو بالکل بتاتا ہے کہ انہوں نے کہاں نمبر کھوئے، جو اسے پیچیدہ اور ترقیاتی کاموں کے لیے معیاری انتخاب بناتا ہے۔
جامع روبرکس ہر چیز کو معیار کے عمومی تاثر کی بنیاد پر ایک مجموعی اسکور میں سمیٹ دیتے ہیں۔ یہ تیز ہیں، یہی وجہ ہے کہ بڑے اندراج والے کورسز اور وقت پر مبنی تحریری تشخیصات ان پر انحصار کرتی ہیں، لیکن جب طلبہ بہتری لانا چاہتے ہیں تو انہیں کم رہنمائی ملتی ہے۔
سنگل پوائنٹ روبرکس صرف ایک کالم میں "ماہر" سطح کی وضاحت کرتے ہیں، اور دونوں طرف گریڈر کے لیے مخصوص نوٹس لکھنے کی جگہ چھوڑتے ہیں کہ کام کہاں سے بہتر تھا یا کم۔ یہ تیاری کا وقت کم کرتے ہیں اور، NC State کے تدریسی وسائل کی رہنمائی کے مطابق، مکمل طور پر پُر شدہ گرڈ کے مقابلے میں زیادہ انفرادی تاثرات دیتے ہیں کیونکہ گریڈر اپنے الفاظ میں لکھتے ہیں بجائے کسی تیار جملے کا انتخاب کرنے کے۔
تینوں میں سے انتخاب مقصد پر منحصر ہے:
- تجزیاتی روبرکس پورٹ فولیوز، کیپ اسٹونز، اور کسی بھی ایسے کام کے لیے استعمال کریں جس میں متعدد الگ مہارت کی جہتیں ہوں۔
- جامع روبرکس زیادہ تعداد میں گریڈنگ کے لیے استعمال کریں جہاں تشخیصی تفصیل سے زیادہ رفتار اہم ہو۔
- سنگل پوائنٹ روبرکس تب استعمال کریں جب آپ تیز سیٹ اپ اور بھرپور، انفرادی تبصرے چاہتے ہوں۔
- AAC&U VALUE روبرک جیسے میٹا-روبرک سے شروع کریں جب آپ کو ایک تصدیق شدہ، کراس انسٹی ٹیوشنل نقطہ آغاز کی ضرورت ہو، پھر اسے موسیقی کی جیوری یا لیب پریکٹیکم جیسے خصوصی کام کے لیے کام سے مخصوص معیار میں تبدیل کریں۔
اسکورنگ روبرک بنانے کا طریقہ: قدم بہ قدم
ایک ایسا روبرک بنانا جو استعمال میں واقعی کام آئے، ایک مخصوص ترتیب کی پیروی کرتا ہے۔ کوئی قدم چھوڑیں اور آپ کو گریڈنگ کے دوران پتہ چلے گا، جب اسے ٹھیک کرنا مہنگا پڑتا ہے۔
- سیکھنے کے نتیجے سے شروع کریں۔ ایک جملے میں کام کی تفصیل لکھیں جو اس سے جڑی ہو کہ طلبہ کو کیا ثابت کرنا چاہیے، نہ صرف انہیں کیا جمع کرانا چاہیے۔
- 3 سے 6 معیار منتخب کریں۔ اس سے زیادہ ہوں تو گریڈر سرسری نظر ڈالنے لگتے ہیں؛ کم ہوں تو آپ واقعی نتیجے کی پیمائش نہیں کر رہے۔ ہر معیار کو اس چیز سے منسلک ہونا چاہیے جو آپ نے واقعی پڑھائی۔
- 3 سے 5 کارکردگی کی سطحیں مقرر کریں۔ Utah Tech کا تشخیصی دفتر وضاحت اور قابلِ استعمال ہونے کے لیے اس حد میں رہنے کی سفارش کرتا ہے؛ اس سے زیادہ سطحیں ہوں تو ریٹرز انہیں قابلِ اعتماد طریقے سے الگ نہیں کر سکتے۔
- قابلِ مشاہدہ تفصیلات لکھیں۔ "مضبوط استدلال ظاہر کرتا ہے" مبہم ہے۔ "ہر دعوے کو متنی شواہد کے کم از کم دو ٹکڑوں سے سہارا دیتا ہے" قابلِ مشاہدہ ہے۔ Cornell کا سینٹر فار ٹیچنگ انوویشن خاص طور پر "دلچسپ" یا "تخلیقی" جیسے الفاظ کے خلاف خبردار کرتا ہے کیونکہ دو گریڈر انہیں ہر بار مختلف طریقے سے سمجھیں گے۔
- وزن کا فیصلہ کریں۔ اگر فارمیٹنگ سے زیادہ طریقہ کار اہم ہے، تو اسے عددی شکل میں بیان کریں۔ ایک سادہ مجموعہ چار معیار کو برابر تقسیم کرنے کے بجائے 30/30/25/15 فیصد پر وزن دے سکتا ہے۔
- حقیقی طلبہ کے کام پر آزمائیں اور نظرثانی کریں۔ Cornell کی رہنمائی اسے حتمی شکل دینے سے پہلے اصل جمع کرائی گئی چیزوں کے خلاف مسودے کی جانچ کرنے کی طرف اشارہ کرتی ہے، اور جو پریکٹیشنرز یہ باقاعدگی سے کرتے ہیں، وہ پاتے ہیں کہ تین سے دس نمونہ پیپرز اسکور کرنا عام طور پر اس بات کو ظاہر کرنے کے لیے کافی ہوتا ہے کہ کوئی تفصیل دو ملحقہ سطحوں کے درمیان امتیاز کرنے میں کہاں ناکام ہوتی ہے۔
ماہرانہ مشورہ: اپنے مسودہ روبرک کے ساتھ پانچ پیپرز کا ڈھیر گریڈ کریں اس سے پہلے کہ آپ ایک بھی حقیقی گریڈ کو چھوئیں۔ اگر آپ مستقل طور پر یہ نہیں بتا سکتے کہ کوئی پیپر "ترقی پذیر" کی بجائے "ماہر" میں کیوں آیا، تو مسئلہ تفصیل میں ہے، طالب علم کے کام میں نہیں۔
روبرک ٹیمپلیٹس جنہیں آپ آج اپنا سکتے ہیں
ٹیمپلیٹس وقت بچاتے ہیں، لیکن صرف تب جب آپ زبان کو اپنے شعبے کے مطابق تبدیل کریں بجائے اسے من و عن نقل کرنے کے۔
ایک مختصر مضمون کے لیے ایک مختصر تجزیاتی روبرک Thesis کی وضاحت، شواہد کا استعمال، اور ترتیب کو چار سطحوں پر اسکور کر سکتا ہے: نمونہ، ماہر، ترقی پذیر، اور ابتدائی۔ پہلے ہر معیار کو برابر وزن دیں، پھر جب آپ دیکھیں کہ طلبہ واقعی کہاں جدوجہد کرتے ہیں تو ایڈجسٹ کریں۔ 12/12 کا کل اسکور اس وقت بامعنی بن جاتا ہے جب ہر سطح کے تحت تفصیلات اتنی مخصوص ہوں کہ اندھا اسکور کرنے والا ساتھی بھی اسی نمبر پر پہنچے۔
ایک جامع روبرک کلاس میں وقت پر مبنی جواب کے لیے اچھا کام کرتا ہے۔ الگ معیار کی بجائے، چار یا پانچ پیراگراف کی طوالت والی بنچ مارک تفصیلات لکھیں، ہر اسکور بینڈ کے لیے ایک، اور طالب علم کے کام کو قریب ترین مجموعی تفصیل سے ملائیں۔ کچھ پروگرام اسے "اسٹیک" طریقے سے مزید تیز کرتے ہیں: پہلے بغیر گریڈ شدہ پیپرز کو تقریباً ڈھیروں میں ترتیب دیں، پھر ہر ڈھیر میں نمبر تفویض کریں۔
ایک سنگل پوائنٹ ٹیمپلیٹ آپ کے معیار کو بائیں طرف درج کرتا ہے جس میں صرف "توقعات پر پورا اترتا ہے" کالم بھرا ہوتا ہے۔ ہاتھ سے لکھے نوٹس کے لیے "نیچے" اور "اوپر" کالم خالی چھوڑ دیں:
- معیار کالم: مہارت کا نام لکھیں (thesis، شواہد، میکانکس)۔
- توقعات پر پورا اترتا ہے کالم: ٹھوس کام کو بیان کرتا ایک واضح جملہ۔
- خدشات / خوبیاں کالم: ہدفی تبصروں کے لیے خالی جگہ۔
ان میں سے کسی کو بھی شعبوں میں ڈھالنے کا مطلب زیادہ تر الفاظ تبدیل کرنا ہے۔ لیب پریکٹیکم روبرک "thesis کی وضاحت" کو "مفروضے کی تشکیل" سے بدل دیتا ہے، جبکہ پریزنٹیشن روبرک آواز کی فراہمی کے لیے ایک معیار شامل کرتا ہے جس کی ایک تحریری مضمون کے روبرک کو کبھی ضرورت نہیں ہوگی۔
انفرادی طلبہ کی گریڈنگ بمقابلہ پروگرام کے نتائج کی تشخیص
روبرک اسکور کا مطلب اس بات پر منحصر ہوتا ہے کہ اسے کون پڑھ رہا ہے۔ جب آپ گریڈ دے رہے ہوتے ہیں، تو نمبر ایک طالب علم کا ہوتا ہے اور ان کے مخصوص کام پر تاثرات کو آگے بڑھاتا ہے۔ جب آپ نتائج کی تشخیص کر رہے ہوتے ہیں، تو وہی روبرک ڈیٹا پوری کلاس یا پروگرام میں جمع ہو جاتا ہے، اور فرد ایک نمونے میں غائب ہو جاتا ہے۔
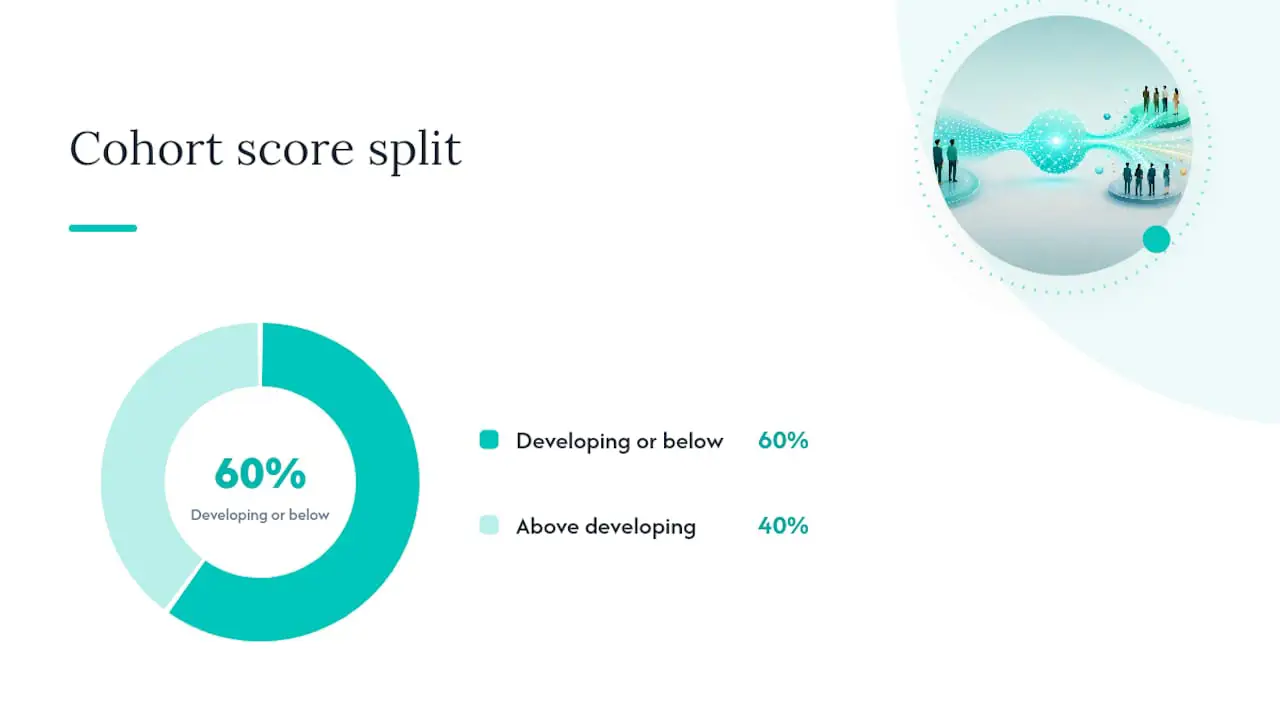
Cornell کی تشخیصی رہنمائی اس فرق کو براہِ راست بیان کرتی ہے: تدریسی تاثرات کے لیے تجزیاتی، معیار کے حساب سے تفصیل کی ضرورت ہوتی ہے، جبکہ پروگرام سطح کے فیصلوں کے لیے بہت سے طلبہ میں جمع شدہ رجحانات کی ضرورت ہوتی ہے۔ اگر فارغ التحصیل ہونے والی جماعت کے 60 فیصد ڈیٹا تجزیہ کے معیار پر "ترقی پذیر" یا اس سے نیچے اسکور کرتے ہیں، تو یہ ایک طالب علم کے لیے تاثرات نہیں ہیں۔ یہ ایک اشارہ ہے کہ نصاب کو تبدیلی کی ضرورت ہے۔
عملی رپورٹنگ کے اقدامات:
- صرف مجموعی اوسط نہیں بلکہ ہر معیار کے لیے اوسط اور تقسیم کا حساب لگائیں۔
- ان معیارات کو نشان زد کریں جہاں اسکور نچلے سرے پر جمع ہو جاتے ہیں۔ یہ آپ کے نصاب کی کمزور جگہ ہے۔
- نتائج کے ساتھ اپنے پائلٹنگ اور نورمنگ کے عمل کو دستاویز کریں۔ منظوری دینے والے جائزہ کار یہ دیکھنا چاہتے ہیں کہ روبرک خود تصدیق شدہ تھا، نہ صرف یہ کہ اسکورز موجود ہیں۔
نورمنگ اور قابلِ اعتماد: متعدد گریڈرز کو مستقل رکھنا
ایک روبرک صرف اتنا ہی قابلِ اعتماد ہوتا ہے جتنے اسے لاگو کرنے والے انسان۔ دو گریڈر ایک ہی تفصیل پڑھ کر مختلف اسکور پر پہنچ سکتے ہیں جب تک کہ انہوں نے پہلے کیلیبریشن نہ کی ہو۔
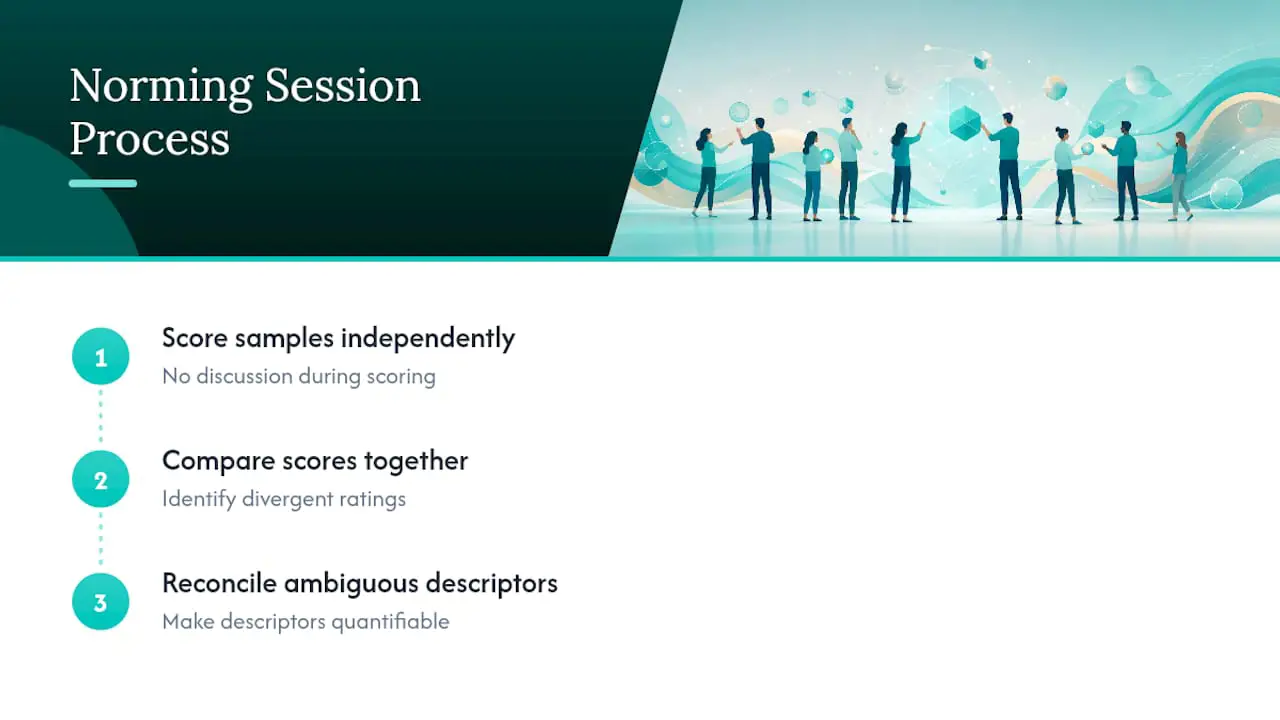
ایک نورمنگ سیشن ایک واضح نمونے کی پیروی کرتا ہے، UC Berkeley کے GSI ٹیچنگ اینڈ ریسورس سینٹر کی رہنمائی کے مطابق: مشترکہ طلبہ کے نمونوں کی ایک مٹھی بھر تعداد جمع کریں، ہر گریڈر کو بغیر بحث کے آزادانہ طور پر انہیں اسکور کرائیں، پھر گروپ کے طور پر نتائج کا موازنہ کریں۔ جہاں بھی اسکور مختلف ہوں، گفتگو بالکل اس بات کو ظاہر کرتی ہے کہ کون سی تفصیل مبہم تھی۔ یہ صلح آشتی کا قدم اکیلے تفصیلات کو دوبارہ لکھنے اور امید کرنے سے زیادہ تیزی سے مسائل کو پکڑتا ہے کہ وہ دوسری بار زیادہ واضح پڑھے جائیں گے۔
دو تفصیل کے مسائل مسلسل سامنے آتے ہیں: ملحقہ سطحوں کے درمیان اوورلیپنگ زبان ("اچھا" شواہد بمقابلہ "مضبوط" شواہد، بغیر قابلِ پیمائش فرق کے) اور مبہم قابلیت دینے والے الفاظ جن کا مختلف پڑھنے والوں کے لیے مختلف مطلب ہوتا ہے۔ حل عام طور پر قابلِ پیمائش زبان ہے: حوالہ کردہ ماخذوں کی تعداد، فی صفحہ مخصوص غلطیاں، ایک صفت کے بجائے ایک قابلِ شمار خصوصیت۔
ماہرانہ مشورہ: اگر دو تربیت یافتہ گریڈر ایک ہی پیپر کو آپ کے پیمانے پر ایک سے زیادہ مکمل سطح کے فرق سے اسکور کریں، تو گریڈر کو الزام نہ دیں۔ پہلے ان دو سطحوں کو الگ کرنے والی تفصیل کو دوبارہ لکھیں۔
بہترین طریقے جو روبرکس کو مفید رکھتے ہیں
روبرک ڈیزائن میں سب سے بڑی ناکامی کا طریقہ دائرے کا پھیلاؤ ہے۔ بارہ معیار والا روبرک زیادہ درست گریڈ نہیں دیتا؛ اس میں صرف زیادہ وقت لگتا ہے اور یہ عدم مستقل مزاجی کو دعوت دیتا ہے، کیونکہ کوئی بھی گریڈر مواد کے لیے پڑھتے ہوئے ایک وقت میں بارہ الگ معیارات کو ذہن میں نہیں رکھ سکتا۔
- معیار کو ان چند تک محدود رکھیں جو آپ جس نتیجے کی پیمائش کر رہے ہیں اس کے لیے واقعی اہم ہوں۔
- سطحوں میں متوازی تفصیل کی ساخت استعمال کریں تاکہ "ماہر" اور "ترقی پذیر" درجے میں مختلف ہوں، نہ کہ مکمل طور پر مختلف جملے کی ساخت سے۔
- گریڈنگ شروع ہونے کے بعد نہیں بلکہ اسائنمنٹ دینے سے پہلے طلبہ کو روبرک دیں۔ یہ ایک روڈ میپ کا کام کرتا ہے، نہ کہ بعد میں ظاہر کیا جانے والا اسکور کارڈ۔
- اسی روبرک زبان کا استعمال کرتے ہوئے ہم-جماعت یا خود تشخیصی بنائیں تاکہ طلبہ معیارات کو اندرونی طور پر سمجھیں بجائے صرف فیصلہ وصول کریں۔
- جب ممکن ہو پورے روبرک کو ایک صفحے پر رکھیں۔ اگر یہ فٹ نہیں ہوتا، تو معیار کی فہرست شاید بہت لمبی ہے۔
تشخیصی دفاتر سے ایک مربوط لیکن محدود اشارہ: سنگل پوائنٹ یا میٹا-روبرک فارمیٹ سے شروع کرنا اور صرف اس وقت پیچیدگی شامل کرنا جب پائلٹنگ سے ثابت ہو کہ اس کی ضرورت ہے، اس چیز کو روکنے میں مدد کرتا ہے جسے پریکٹیشنرز "روبرک کریپ" کہتے ہیں، جہاں ایک صاف آلہ آہستہ آہستہ ایسے معیارات جمع کر لیتا ہے جنہیں کوئی دراصل استعمال نہیں کرتا۔
Talent Approved روبرک پر مبنی تشخیص میں کہاں فٹ بیٹھتا ہے
اوپر بیان کردہ تمام چیزیں ایک کلاس روم کے لیے ٹھیک پیمانے پر چلتی ہیں۔ جب ایک ہائرنگ ٹیم ایک ہی معیار کے خلاف درجنوں امیدواروں کو اسکور کر رہی ہو تو یہ مشکل ہو جاتا ہے۔ Talent Approved کا Magic Create فیچر ملازمت کی تفصیل یا مہارت کی فہرست سے کردار کے مخصوص تشخیصات بناتا ہے، سوالات کو معیار سے اس طرح جوڑتا ہے جیسے ایک اچھی طرح بنا ہوا روبرک معیار کو سیکھنے کے نتائج سے جوڑتا ہے۔ AI سے تیار کردہ خلاصے ان معیارات کے خلاف جوابات کو مستقل طور پر اسکور کرتے ہیں، جبکہ سیشن ری پلے اور اینٹی چیٹ مانیٹرنگ ریموٹ ٹیسٹنگ کی درستگی کی حفاظت اسی طرح کرتی ہے جیسے ذاتی نورمنگ گریڈنگ کی مستقل مزاجی کی حفاظت کرتی ہے۔ امیدوار تشخیص کے معیار پر متعلقہ مطالعہ ہائرنگ سائیڈ کے اطلاق کو مزید گہرائی سے احاطہ کرتا ہے۔
میں نے روبرک کی تفصیل اور گریڈنگ کے وقت کے درمیان توازن کے بارے میں کیا سیکھا
وہ روبرکس جو واقعی استعمال ہوتے ہیں وہ سب سے زیادہ مکمل نہیں ہوتے۔ وہ ہیں جنہیں ایک گریڈر تشخیصی قدر کھوئے بغیر فی جمع کرائی گئی چیز دو منٹ سے کم میں لاگو کر سکے، جس کا مطلب عام طور پر ان معیارات کو کاٹنا ہے جنہیں آپ رکھنے کا لالچ رکھتے ہیں۔
اس ہفتے کرنے کے لیے تین کام: اپنے اگلے اسائنمنٹ کے لیے تین سے چھ معیارات استعمال کرتے ہوئے ایک روبرک کا مسودہ بنائیں، لائیو ہونے سے پہلے اسے تین حقیقی نمونوں پر آزمائیں، اور اگر آپ کسی اور کے ساتھ گریڈ کرتے ہیں، تو دو مشترکہ پیپرز پر پندرہ منٹ کا نورمنگ سیشن چلائیں۔
— Jimmie
Talent Approved کے ساتھ اپنی روبرک پریکٹس کو وسعت دیں
ایک عمدہ روبرک بنانا قابلِ انتظام ہے۔ اسے پچاس امیدوار کی جمع کرائی گئی چیزوں میں جائزہ کاروں کے درمیان صفر انحراف کے ساتھ مستقل طور پر لاگو کرنا وہ جگہ ہے جہاں زیادہ تر دستی عمل ٹوٹ جاتے ہیں۔ Talent Approved بالکل اسی خلا کے لیے بنایا گیا ہے: ہر جواب کو آپ کے معیار کے خلاف ہاتھ سے اسکور کرنے کی بجائے، Magic Create ایک کردار کی تفصیل کو منٹوں میں ایک منظم، روبرک سے منسلک تشخیص میں تبدیل کر دیتا ہے، اور AI سے تیار کردہ خلاصے آپ کی اسکورنگ منطق کو ہر بار ایک ہی طریقے سے لاگو کرتے ہیں، چاہے وہ تیسرا امیدوار ہو یا تین سو واں۔
اینٹی چیٹ مانیٹرنگ اور سیشن ری پلے کا مطلب ہے کہ آپ جو اسکور جمع کر رہے ہیں ان پر بھروسہ کر سکتے ہیں، وہی درستگی کی فکر جو کلاس روم میں نورمنگ سیشنز کو آگے بڑھاتی ہے۔ اگر آپ دیکھنا چاہتے ہیں کہ معیار پر مبنی اسکورنگ ایک تعلیمی روبرک سے ہائرنگ ورک فلو میں کیسے منتقل ہوتی ہے، تو T-shaped مہارتوں کی تشخیص کا گائیڈ پیشہ ورانہ مہارت کے پروفائلز کے لیے روبرک زبان کو اپنانے کا طریقہ بتاتا ہے۔ Talent Approved پلیٹ فارم کو دریافت کر کے شروع کریں اور پہلی تشخیص اس کردار کی تفصیل سے بنائیں جو آپ کے پاس پہلے سے موجود ہے۔
روبرک ڈیزائن پر مزید گہرائی میں کہاں جائیں
ہاتھ سے کام کرنے والی ٹیمپلیٹ لائبریریوں کے لیے، Utah Tech کا تشخیصی دفتر اور NC State کے تدریسی وسائل دونوں فارمیٹس میں قابلِ ڈاؤن لوڈ مثالیں پیش کرتے ہیں۔ Cornell کا سینٹر فار ٹیچنگ انوویشن تخلیق کے عمل کو تفصیل سے احاطہ کرتا ہے، جبکہ Northern Illinois University کا سینٹر فار انوویٹو ٹیچنگ اینڈ لرننگ شعبے کے مطابق ڈھالنے کے لیے مفید ہے۔ منظوری کے لیے تیار معیارات کے لیے، AAC&U VALUE روبرکس معیاری حوالہ نقطہ رہتے ہیں۔
ماخذ
- اسکورنگ روبرک بنانا | تعلیمی تشخیص (Utah Tech University)
- روبرکس، اسکورنگ اور گریڈنگ — تشخیصی ہینڈ بک (University of Michigan انجینئرنگ)
- روبرکس کا استعمال — سینٹر فار ٹیچنگ انوویشن (Cornell University)
- تشخیص کے لیے روبرکس — سینٹر فار انوویٹو ٹیچنگ اینڈ لرننگ (Northern Illinois University)
- روبرک بہترین طریقے، مثالیں، اور ٹیمپلیٹس (NCSU تدریسی وسائل)
اکثر پوچھے جانے والے سوالات
میں تشخیص کے لیے اسکورنگ روبرک کیسے بناؤں؟
روبرک کو ایک مخصوص سیکھنے کے نتیجے سے منسلک کریں، 3 سے 6 معیار منتخب کریں، 3 سے 5 کارکردگی کی سطحیں مقرر کریں، ہر سطح کے لیے قابلِ مشاہدہ تفصیلات لکھیں، پھر حتمی شکل دینے سے پہلے اسے حقیقی طلبہ کے کام پر آزمائیں۔
اسکورنگ روبرکس کیا ہیں؟
اسکورنگ روبرکس منظم تشخیصی آلات ہیں جو کسی کام کو نامزد معیارات میں تقسیم کرتے ہیں اور بیان کرتے ہیں کہ ہر کارکردگی کی سطح پر معیار کیسا نظر آتا ہے، ساپیکش گریڈنگ کو مستقل معیارات سے بدل کر۔
تشخیصی روبرک کیا ہے؟
ایک تشخیصی روبرک وہی آلہ ہے جو کسی کلاس یا پروگرام میں سیکھنے کے نتائج کی پیمائش کے لیے لاگو ہوتا ہے، اکثر انفرادی تاثرات کی بجائے نمونوں کو پہچاننے کے لیے جمع کیا جاتا ہے۔
اسکورنگ روبرک کے چار بنیادی حصے کیا ہیں؟
چار حصے ہیں: کام کی تفصیل، تشخیصی معیار، کارکردگی کی سطحیں، اور تفصیلات جو بتاتی ہیں کہ کارکردگی کی ہر سطح کیسی نظر آتی ہے۔
کیا AI آلات بہت سی تشخیصات میں روبرکس کو مستقل طور پر لاگو کرنے میں مدد کر سکتے ہیں؟
جی ہاں۔ Talent Approved جیسے پلیٹ فارم AI سے تیار کردہ اسکورنگ خلاصوں کا استعمال کرتے ہیں تاکہ بڑی تعداد میں جوابات میں ایک ہی معیار کو مستقل طور پر لاگو کیا جا سکے، جو کہ انسانی گریڈرز کے لیے نورمنگ جو کام کرتی ہے اس کا آئینہ دار ہے۔