
45–90 minutters dataanalytikertest for HR-team
Den beste dataanalytikervurderingen tester flere arbeidsoppgaver hentet direkte fra stillingens faktiske ansvarsområder, poengssatt etter en transparent rubrikk og levert som en tidsbegrenset hjemmeoppgave eller et kort live-laboratorium. Pilottest den internt før den når en reell kandidat. Denne modellen gir raskere, mer rettferdig og mer prediktiv ansettelse enn CV-gjennomganger eller trivia-baserte quizer noen gang vil gjøre. Plattformer som Talent Approved finnes nettopp for å bygge og poengssette denne typen vurderinger uten det manuelle merarbeidet.
TL;DR:
- Gjennomfør vurderinger med et tydelig fokus på faktiske dataoppgaver som datarensing, skriving av SQL-spørringer og forklaring av funn for å sikre praktisk jobbklarhet.
- Tidsberegn oppgaver hensiktsmessig, med enkel datarensing på 30 til 45 minutter og mer komplekse SQL-problemer på opptil 60 minutter, justert etter kandidatens ansiennitet.
- Bruk rubrikker med flere akser som dekker korrekthet, tilnærming, tolkning, kommunikasjon og reproduserbarhet for å rangere kandidater pålitelig og sette rettferdige terskler.
- Inkluder randomiserte data, tydelige instruksjoner og anti-juksverktøy for vurderinger med høyere innsats for å forhindre juks uten å skade kandidatopplevelsen.
- Følg jevnlig med på fullføring, beståelse og tid-til-ansettelse-målinger for å kalibrere vurderinger, med vekt på små, fokuserte oppgaver som forutsier faktisk jobbprestasjon.
Innholdsfortegnelse
- Hva er en dataanalytikervurdering, og hva bør den måle?
- Hvordan omsetter du en stillingsbeskrivelse til testbare oppgaver?
- Hvilket vurderingsformat passer til en dataanalytikerrolle?
- Hvordan bør du poengssette og rangere kandidater rettferdig?
- Hvordan forhindrer du juks uten å skade kandidatopplevelsen?
- Hvordan vet du om vurderingen din faktisk fungerer?
- Hva jeg har lært av å se disse pilotene lykkes eller mislykkes
- Bygg vurderingen din uten å starte fra et blankt ark
- Videre lesning om bygging og skalering av vurderinger
- FAQ
Hva er en dataanalytikervurdering, og hva bør den måle?
En dataanalytikervurdering er en strukturert test som måler om en kandidat faktisk kan utføre jobben: rense rotete data, skrive fungerende SQL, tolke resultater og forklare funn til noen som ikke rører regneark til daglig. Det er noe annet enn en dataanalyseferdighetstест bygget for jobbsøkere til å øve på i sin egen tid. Dette er et verktøy HR-team og ansettelsesansvarlige bygger og kontrollerer, knyttet til en spesifikk stillingsbeskrivelse og poengssatt mot en rubrikk teamet ditt definerer.
Feilen de fleste ansettelsesteam gjør, er å teste kunnskap i stedet for oppgaver. En kandidat som kan definere «median absolutt avvik» utenat, kan likevel bryte sammen når de får en regneark full av dupliktrader og inkonsistente datoformater. Løsningen begynner med å kartlegge selve rollen – ikke CV-en.
Hvordan omsetter du en stillingsbeskrivelse til testbare oppgaver?
Begynn med å hente ut flere kjerne, observerbare oppgaver direkte fra stillingsbeskrivelsen. Denne jobb-oppgaveanalysen er grunnlaget for hele vurderingen, og å hoppe over den er den aller viktigste grunnen til at vurderinger ikke klarer å forutsi prestasjoner. Å bygge testspørsmål direkte fra stillingsbeskrivelsen forbedrer konsekvent hvor godt en vurdering forutsier resultater på jobb, ifølge ansettelsesguider for bedrifter som følger denne sammenhengen.
For en typisk dataanalytikerrolle ser oppgavelisten vanligvis slik ut:
- Rense et datasett med manglende verdier, duplikater eller inkonsistent formatering
- Skrive SQL-sammenslåinger på tvers av to eller tre relaterte tabeller
- Definere en metrikk tydelig nok til at to personer ville beregne den på samme måte
- Bygge et diagram eller en kort fortelling som forklarer et funn til en ikke-teknisk interessent
- Oppdage en feil eller et avvik i noen andres analyse
Ansiennitet endrer kravene, ikke oppgavelisten. En kandidat på inngangsnivå får kanskje en enkelt ren tabell og 45 minutter. En senioranalytikerkandidiat får tre rotete, løst relaterte tabeller, uklare krav og 90 minutter – fordi en del av det du tester, er hvordan de håndterer uklarhet.
Før denne vurderingen noen gang møter en reell kandidat, kjør den med to eller tre nåværende ansatte i ditt eget analyteam. Scorene deres blir referansepunktet ditt, og tilbakemeldingene deres forteller deg om oppgaven tar 45 minutter eller hemmelig tar to timer.
Pro Tips: Hvis dine egne analytikere ikke klarer å fullføre oppgaven innen den avsatte tiden, vil ingen kandidat gjøre det heller. Juster klokken før du justerer forventningene dine til kandidatene.
Hvilket vurderingsformat passer til en dataanalytikerrolle?
Formatet avgjør hvor mye signal du får og hvor mye friksjon kandidaten opplever. En kort live-screening er rask og vanskelig å forfalske, men avdekker bare overfladisk flyt. En tidsbegrenset hjemmeoppgave viser reell problemløsning under lavt press, men er mer sårbar for ekstern hjelp. Et praktisk laboratorium med et isolert datasett befinner seg i midten: realistisk, vanskeligere å manipulere og fortsatt hensynsfullt overfor kandidatens tid. Formatvalg innebærer konsekvent en avveining mellom troskap, kandidatbelastning og risiko for juks, og kortere, mer relevante oppgaver har en tendens til å gi renere fullføringsdata enn lange, generiske oppgaver.
Tre oppgavetyper som fungerer godt for de fleste dataanalytikerstillinger:
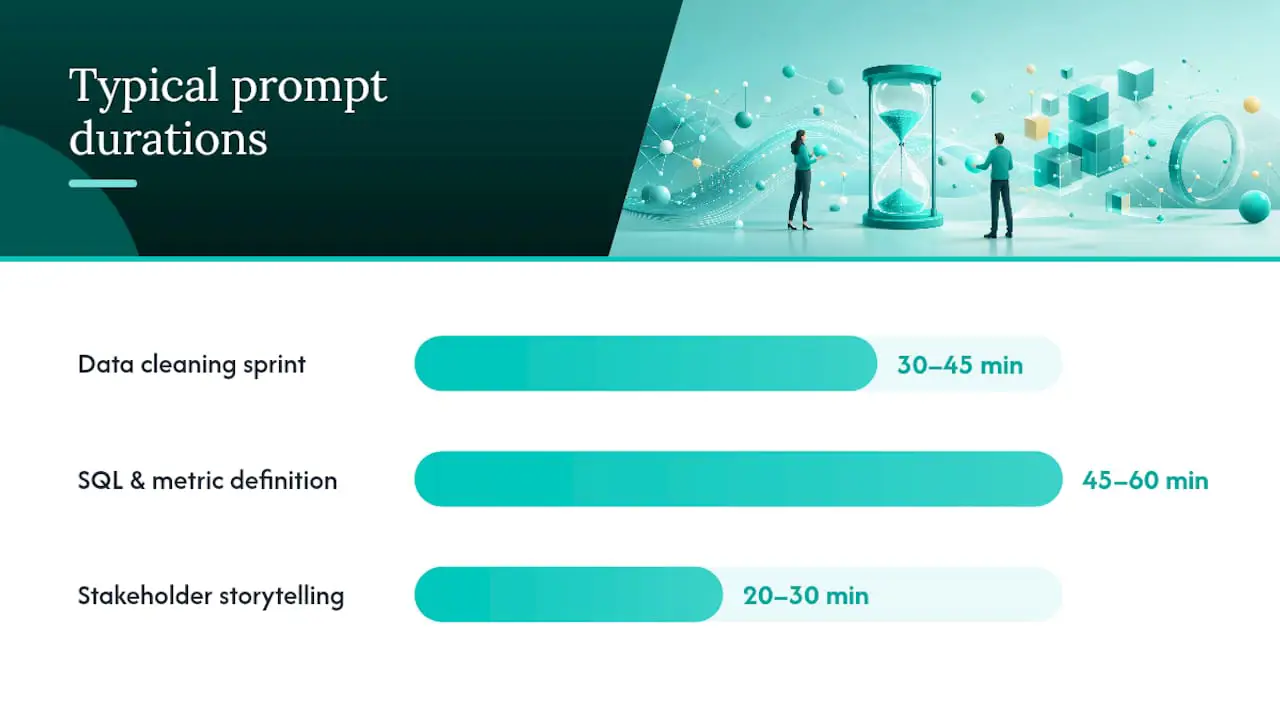
- Datarensesprint (30 til 45 minutter). Gi en rå CSV-fil med dupliktrader, inkonsistente datoformater og noen null-verdier. Be kandidaten levere et rent datasett pluss en kort liste over hva de rettet og hvorfor.
- SQL og metrikkdefinisjon (45 til 60 minutter). Gi to relaterte tabeller og be om en spørring som svarer på et spesifikt forretningsspørsmål, pluss en skriftlig definisjon av metrikken de beregnet.
- Interessentfortelling (20 til 30 minutter, live eller innspilt). Gi et ferdig diagram eller en oppsummeringstabell og be kandidaten forklare det til en hypotetisk markedsføringsdirektør på under tre minutter.
Legg inn noen realistiske særtrekk i hjemmeoppgavedataene, som et valutafelt blandet med tekst, slik at oppgaven føles som en vanlig tirsdag på kontoret snarere enn et puslespill.
Hvordan bør du poengssette og rangere kandidater rettferdig?
Poengssett alle innleveringer mot en vektet rubrikk med fire eller fem akser, ikke en enkelt bestått-eller-ikke-bestått-bryter. Rubrikker med flere akser gir mer pålitelig rangering enn enkeltscoring fordi de tvinger vurderere til å skille mellom «fikk riktig svar» og «kom frem til det på riktig måte».
En solid rubrikk for en dataanalytikervurdering dekker vanligvis:
- Korrekthet — samsvarte resultatet med det forventede, og hvor nær var det hvis ikke?
- Tilnærming — valgte kandidaten en fornuftig metode, eller var det flaks?
- Tolkning — trakk de riktig konklusjon fra sitt eget resultat?
- Kommunikasjon — kunne en ikke-analytiker forstå forklaringen deres?
- Reproduserbarhet — kunne en annen analytiker kjøre trinnene på nytt og få samme svar?
Vekt korrekthet og tilnærming tyngst for juniorroller, og flytt vekten mot tolkning og kommunikasjon ettersom ansiennitet øker. Sett din «gå videre til intervju»-terskel ved pilotens referansepoengscore, ikke et vilkårlig rundt tall.
AI-genererte oppsummeringer kan fremskynde gjennomgangen ved å flagge sterke og svake innleveringer før et menneske leser dem linje for linje, men de fungerer best som en andreoppfatning. En vurderer som aldri åpner det faktiske arbeidet, vurderer oppsummeringen, ikke kandidaten. Vurderingsanalyse som sporer fullføring og beståelsesfordeling hjelper deg med å kontrollere om rubrikkvektingen faktisk skiller sterke kandidater fra svake over tid.
Hvordan forhindrer du juks uten å skade kandidatopplevelsen?
Anti-jukskontroller bør samsvare med rollens innsatsnivå, ikke maksimere mistanke. En juniorsrscreen trenger kanskje bare randomiserte datasettfrø. En sluttrundevurdering for en senioranalytikerrolle kan berettiges med sesjonsavspilling eller nettleserlåsing. Å randomisere dataene hver kandidat mottar, reduserer svarudveksling uten å endre det du faktisk vurderer.
Uansett hvilke kontroller du velger, kombiner dem med tydelige instruksjoner: oppgi tidsgrensen, navngi verktøyene og bibliotekene som er tillatt, og si klart og tydelig om søkemotorer er tillatt. Uklare regler fører til flere legitime feil enn faktisk juks, og kortere, tydelig avgrensede tester har en tendens til å gi bedre fullføringsrater enn åpne oppgaver.
Automatisering fjerner det manuelle slepet:
- Utløs vurderingsinvitasjoner automatisk når en kandidat når et bestemt ATS-stadium
- Rut fullførte vurderinger til en vurderingskø i stedet for en innboks
- Send scorer tilbake til ATS-en via en webhook slik at ingen trenger å taste inn resultater på nytt
Pro Tips: Test din egen invitasjonsflyt slik en kandidat ville oppleve den, før lansering. Ødelagte lenker og forvirrende instruksjoner dreper fullføringsratene raskere enn noe vanskelig SQL-spørsmål.
Hvordan vet du om vurderingen din faktisk fungerer?
Følg fire tall fra dag én: fullføringsrate, beståelsesrate, tid-til-ansettelse og sparede intervjuertimer. En beståelsesrate som aldri endrer seg, uansett hvem som søker, tyder på at rubrikkens terskel er feilkalibrert snarere enn at kandidatpoolen er uvanlig sterk eller svak.
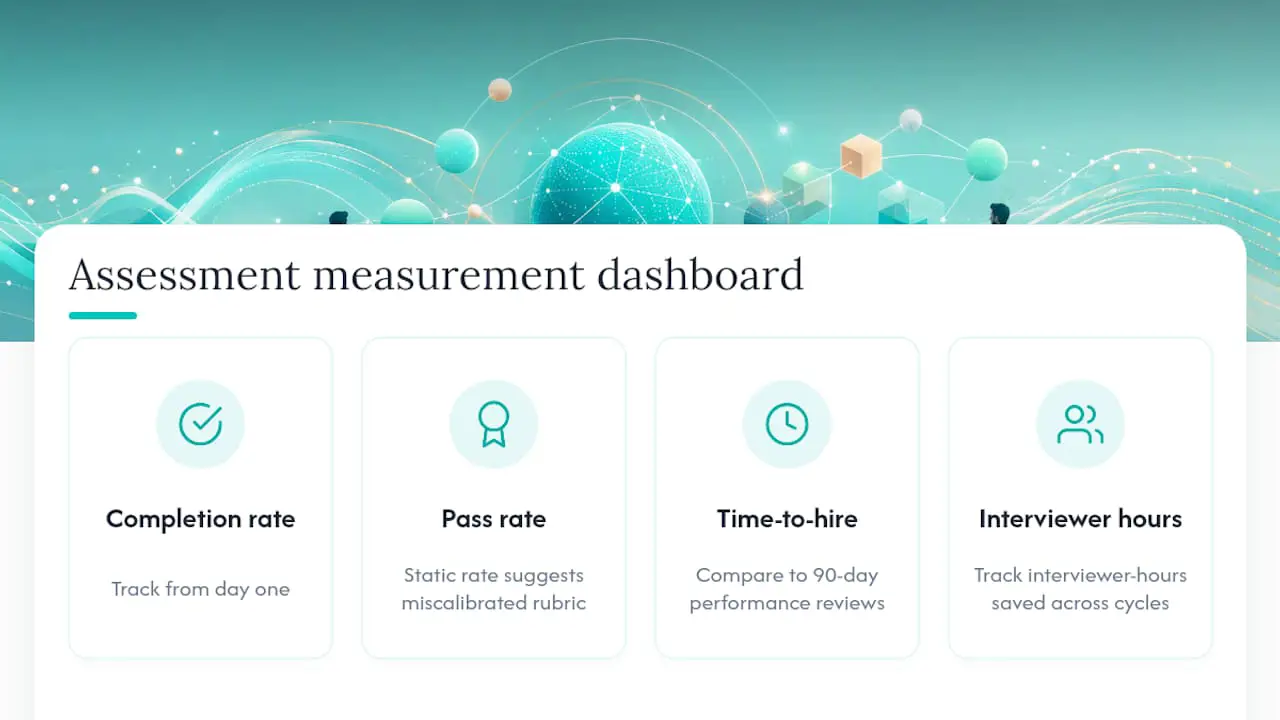
Kjør piloten mot en liten gruppe først, og sammenlign deretter tidlige vurderingsscorer med faktiske 90-dagers prestasjonsgjennomganger når de ansatte er i jobb. Den korrelasjonen, selv fra et fåtall ansettelser, forteller deg mer enn noen teoretisk scoringsmodell. Å spore fullføring, beståelsesfordeling og tid-på-oppgave over flere sykluser lar deg også fange opp scoredrift eller skjevhet før det stille påvirker hvem som blir ansatt.
Hva jeg har lært av å se disse pilotene lykkes eller mislykkes
Pilotene som mislykkes, deler nesten alltid én grunnleggende årsak: oppgavelisten var for bred, eller ingen hadde referansetestet den mot en reell ansatt før den nådde en kandidat. Team blir begeistret og prøver å teste seks kompetanser i én vurdering, og resultatet er en oppblåst oppgave som utmatter kandidatene uten å skjerpe signalet. Tre fokuserte oppgaver poengssatt godt slår seks overfladiske oppgaver hver gang.
Den andre lærdommen er mer direkte. Trivia-spørsmål om statistisk terminologi føles grundige, men forutsier nesten ingenting om hvorvidt noen kan rense et virkelig datasett under en deadline. Oppgavejustering til faktiske jobbresultater er hele spillet. Brukt ærlig erstatter ikke AI-genererte oppsummeringer og anti-juksverktøy en vurderers skjønn. De rydder bare unna støyen slik at dette skjønnet brukes på innleveringene som faktisk fortjener en grundig gjennomlesning.
— Jimmie
Bygg vurderingen din uten å starte fra et blankt ark
Talent Approved gjør arbeidsflyten ovenfor til noe du kan lansere samme ettermiddag som du leser dette. Legg inn en stillingsbeskrivelse eller en ferdighetsliste i Magic Create, og den genererer en skreddersydd, rollespesifikk vurdering på minutter i stedet for de dagene det vanligvis tar å skrive oppgaver, rubrikker og instruksjoner fra bunnen av.
Hver vurdering kjøres med innebygde anti-jukskontroller, inkludert skjerm- og webkameraovervåking og sesjonsavspilling, slik at du ikke trenger å velge mellom kandidattillit og resultatintegritet. AI-genererte oppsummeringer gir vurderere en rask første gjennomlesning av hver innlevering, og kandidatrangeringer omgjør rubrikkscore til en kortliste uten et regneark i sikte. Fordi prisen er betal-etter-bruk uten abonnementsforpliktelse, kan du teste modellen på din neste ledige stilling ved å besøke plattformen for gjeldende detaljer. Besøk Talent Approved-plattformen for å bygge din første vurdering fra en eksisterende stillingsbeskrivelse og se hvor raskt en pilot kommer sammen.
Videre lesning om bygging og skalering av vurderinger
- Hvordan vurderinger driver kandidatrangering forklarer hvordan rubrikkscorer omsettes til en brukbar kortliste.
- Tekniske vurderingsformater for HR-team bryter ned formatavveininger mer detaljert.
- Eksempler på markedsføringsanalysedashbord tilbyr maler som er verdt å tilpasse til oppgavetyper for interessentfortelling.
FAQ
Hvor lang tid bør en dataanalytikervurdering ta?
De fleste effektive vurderinger varer 45 til 90 minutter totalt, fordelt på 2 til 3 oppgaver. Lengre tester skader vanligvis fullføringsratene mer enn de forbedrer signalet.
Hvilke ferdigheter bør en dataanalytikerferdighetstest faktisk dekke?
Fokuser på datarensing, SQL-sammenslåinger, metrikkdefinisjon og interessentkommunikasjon. Statistikkunnskap er viktig, men bare når den er knyttet til en oppgave kandidaten faktisk må fullføre.
Bør du bruke et live-laboratorium eller en hjemmeoppgave?
Hjemmeoppgaver fungerer godt for tidlig screening fordi de er lavterskel og enklere å skalere, mens live-laboratorier eller korte live-screeninger passer til sluttunder der du ønsker å se noen tenke i sanntid.
Hvordan forhindrer du at kandidater jukser på en hjemmeoppgave?
Randomiser datasettet hver kandidat mottar, sett tydelige tidsgrenser, og bruk sesjonsavspilling eller nettleserovervåking for sluttunder med høyere innsats. Verktøy som Talent Approved bygger disse kontrollene direkte inn i vurderingen.
Hva er en god beståelsesrate for en dataanalytikervurdering?
Det finnes ingen universell sats, men en rate som aldri endrer seg på tvers av svært ulike søkergrupper, betyr vanligvis at rubrikkens terskel trenger rekalibrering – ikke at ansettelsesgruppen din er uvanlig konsistent.