
45–90 Minuters Dataanalytikertest för HR-team
Det bästa testet för dataanalytiker utvärderar flera arbetsuppgifter hämtade direkt från rollens faktiska ansvarsområden, bedöms enligt ett transparent poängsystem och levereras som ett tidsbegränsat hemuppgiftstest eller ett kort liveprov. Testa det internt innan det möter en riktig kandidat. Den modellen ger snabbare, rättvisare och mer förutsägbar rekrytering än CV-granskning eller triviafrågor någonsin kommer att göra. Plattformar som Talent Approved finns just för att bygga och poängsätta den här typen av bedömning utan manuellt merarbete.
Sammanfattning:
- Genomför bedömningar med ett tydligt fokus på faktiska datauppgifter, som att rensa data, skriva SQL-frågor och förklara resultat, för att säkerställa praktisk yrkesförmåga.
- Tidsanpassa uppgifterna på ett lämpligt sätt, med enkel datarensning på 30 till 45 minuter och mer komplexa SQL-problem på upp till 60 minuter, och justera baserat på kandidatens erfarenhetsnivå.
- Använd flerdimensionella bedömningsrubriker som täcker korrekthet, tillvägagångssätt, tolkning, kommunikation och reproducerbarhet för att tillförlitligt rangordna kandidater och sätta rättvisa tröskelvärden.
- Inkludera slumpmässig data, tydliga instruktioner och verktyg mot fusk vid bedömningar med högre insatser för att förhindra fusk utan att skada kandidatupplevelsen.
- Spåra regelbundet statistik för genomförande, godkännande och tid-till-anställning för att kalibrera bedömningar, med betoning på små, fokuserade uppgifter som förutsäger faktisk arbetsprestation.
Innehållsförteckning
- Vad är ett test för dataanalytiker, och vad ska det mäta?
- Hur omvandlar du en jobbbeskrivning till testbara uppgifter?
- Vilket bedömningsformat passar en dataanalytikerroll?
- Hur ska du poängsätta och rangordna kandidater på ett rättvist sätt?
- Hur förhindrar du fusk utan att skada kandidatupplevelsen?
- Hur vet du om din bedömning faktiskt fungerar?
- Vad jag lärt mig av att bevittna dessa pilotprojekt lyckas eller misslyckas
- Bygg din bedömning utan att börja från noll
- Vidare läsning om att bygga och skala bedömningar
- Vanliga frågor
Vad är ett test för dataanalytiker, och vad ska det mäta?
Ett test för dataanalytiker är ett strukturerat prov som mäter om en kandidat faktiskt kan utföra arbetet: rensa rörig data, skriva fungerande SQL, tolka resultat och förklara fynd till någon som inte jobbar med kalkylblad till vardags. Det skiljer sig från ett test i dataanalyskunskaper byggt för jobpsökande att öva på egen hand. Det här är ett verktyg som HR-team och rekryterande chefer bygger och kontrollerar, kopplat till en specifik jobbbeskrivning och poängsatt enligt en bedömningsrubrik som ditt team definierar.
Misstaget de flesta rekryteringsteam gör är att testa kunskap i stället för uppgifter. En kandidat som kan definiera "median absolut avvikelse" utantill kanske ändå misslyckas när de får ett kalkylblad fullt av dubbletter och inkonsekventa datumformat. Lösningen börjar med att kartlägga själva rollen, inte CV:t.
Hur omvandlar du en jobbbeskrivning till testbara uppgifter?
Börja med att plocka ut ett antal centrala, observerbara uppgifter direkt från jobbbeskrivningen. Den här uppgiftsanalysen är grunden för hela bedömningen, och att hoppa över den är den enskilt största anledningen till att bedömningar misslyckas med att förutsäga arbetsprestation. Att bygga testfrågor direkt från jobbbeskrivningen förbättrar konsekvent hur väl en bedömning förutsäger resultat på jobbet, enligt rekryteringsguider för stora organisationer som spårar detta samband.
För en typisk dataanalytikerroll brukar uppgiftslistan se ut ungefär så här:
- Rensa ett dataset med saknade värden, dubbletter eller inkonsekvent formatering
- Skriva SQL-kopplingar över två eller tre relaterade tabeller
- Definiera ett mått tillräckligt tydligt för att två personer ska beräkna det på samma sätt
- Bygga ett diagram eller en kort berättelse som förklarar ett fynd för en icke-teknisk intressent
- Identifiera ett fel eller ett avvikande värde i någon annans analys
Erfarenhetsnivå ändrar ribban, inte uppgiftslistan. En kandidat på grundnivå kanske får en enda ren tabell och 45 minuter. En kandidat för en seniortjänst får tre röriga, löst relaterade tabeller, otydliga krav och 90 minuter – eftersom en del av det du testar är hur de hanterar otydlighet.
Innan den här bedömningen möter en riktig kandidat, genomför den med två eller tre nuvarande medarbetare på ditt eget analysteam. Deras poäng blir din riktmärke, och deras återkoppling berättar om uppgiften tar 45 minuter eller hemligen tar två timmar.
Proffstips: Om dina egna analytiker inte kan slutföra uppgiften inom den tid du avsatt, kommer ingen kandidat heller att göra det. Justera klockan innan du justerar dina förväntningar på kandidaterna.
Vilket bedömningsformat passar en dataanalytikerroll?
Formatet avgör hur mycket signal du får och hur mycket friktion kandidaten känner. En kort livescreening är snabb och svår att fejka, men den visar bara ytlig språklig behärskning. Ett tidsbegränsat hemuppgiftstest visar verklig problemlösning under lågt tryck, men det är mer sårbart för utomstående hjälp. Ett praktiskt prov med ett avgränsat dataset befinner sig i mitten: realistiskt, svårare att fuska i och ändå respektfullt mot kandidatens tid. Formatval gör konsekvent en avvägning mellan trovärdighet och kandidatbörda och fuskrisk, och kortare, mer relevanta uppgifter tenderar att ge renare data om genomförandegrad än långa, generiska sådana.
Tre uppgiftstyper som fungerar bra för de flesta rekryteringar av dataanalytiker:
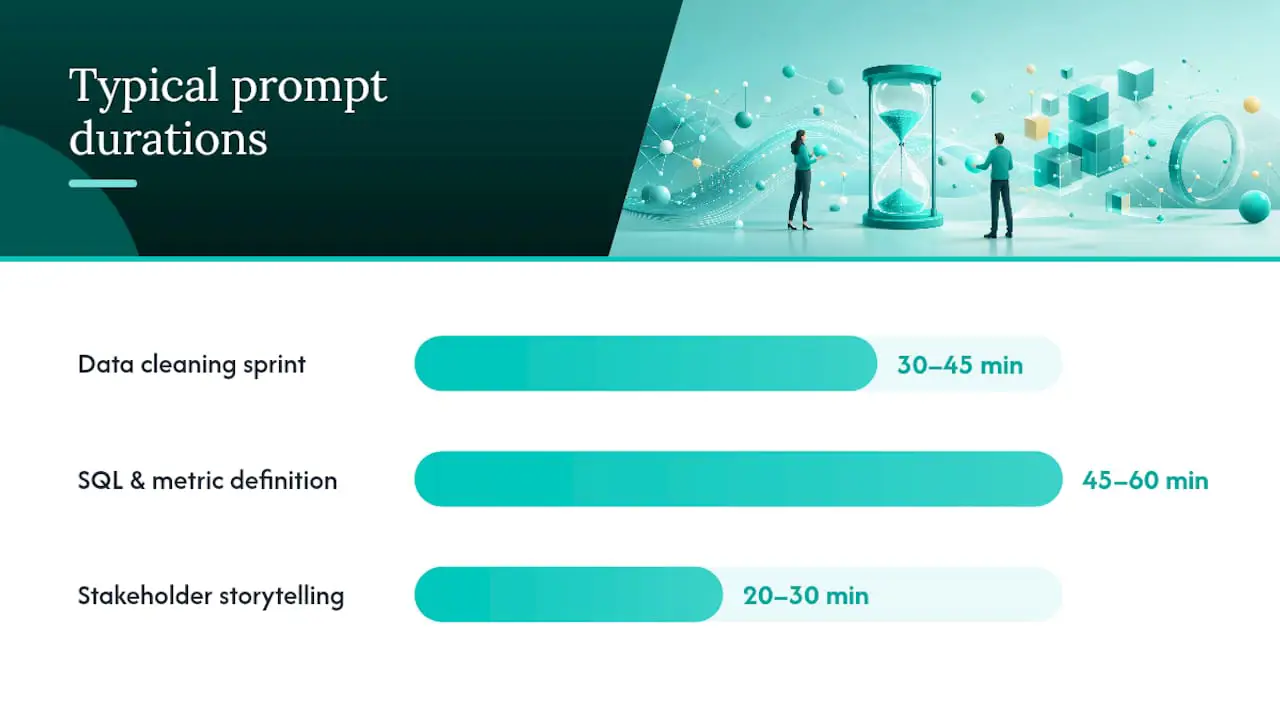
- Datarensningssprint (30 till 45 minuter). Ge en rådata-CSV med dubbletter, inkonsekventa datumformat och ett antal null-värden. Be kandidaten producera ett rent dataset plus en kort lista över vad de åtgärdade och varför.
- SQL och måttdefinition (45 till 60 minuter). Tillhandahåll två relaterade tabeller och be om en fråga som besvarar en specifik affärsfråga, plus en skriftlig definition av det mått de beräknade.
- Berättande för intressenter (20 till 30 minuter, live eller inspelat). Överlämna ett färdigt diagram eller en sammanfattningstabell och be kandidaten förklara det för en hypotetisk marknadsdirektör på under tre minuter.
Lägg in några realistiska egenheter i hemuppgiftsdatan, som ett valutafält blandat med text, så att uppgiften känns som en vanlig tisdag på kontoret snarare än ett pussel.
Hur ska du poängsätta och rangordna kandidater på ett rättvist sätt?
Poängsätt varje inlämning mot en viktad bedömningsrubrik med fyra eller fem dimensioner, inte ett enda godkänt-eller-underkänt-alternativ. Flerdimensionella bedömningsrubriker ger mer tillförlitlig rangordning än enbetygsbedömning eftersom de tvingar granskare att skilja på "fick rätt svar" och "kom dit på rätt sätt."
En solid bedömningsrubrik för ett dataanalytikertest täcker vanligtvis:
- Korrekthet — stämde resultatet med det förväntade resultatet, och hur nära var det om inte?
- Tillvägagångssätt — valde kandidaten en sund metod, eller hade de tur?
- Tolkning — drog de rätt slutsats från sina egna resultat?
- Kommunikation — kunde en icke-analytiker förstå deras förklaring?
- Reproducerbarhet — kunde en annan analytiker köra om deras steg och få samma svar?
Ge korrekthet och tillvägagångssätt störst vikt för juniora roller, och flytta vikt mot tolkning och kommunikation när erfarenhetsnivån ökar. Sätt ditt tröskelvärde för "gå vidare till intervju" vid ditt pilotbenchmarkvärde, inte ett godtyckligt runt tal.
AI-genererade sammanfattningar kan påskynda granskningen genom att flagga starka och svaga inlämningar innan en person läser dem rad för rad, men de fungerar bäst som en andra åsikt. En granskare som aldrig öppnar det faktiska arbetet bedömer sammanfattningen, inte kandidaten. Bedömningsanalys som spårar genomförande och poängfördelning hjälper dig att kontrollera om din rubriks viktning faktiskt separerar starka kandidater från svaga över tid.
Hur förhindrar du fusk utan att skada kandidatupplevelsen?
Åtgärder mot fusk bör motsvara rollens insatsnivå, inte maximera misstänksamhet. En grundläggande screening kanske bara behöver slumpmässiga dataseeds. En slutrundessbedömning för en seniortjänst som analytiker kan motivera sessionsuppspelning eller låst webbläsare. Att slumpmässigt variera den data varje kandidat får minskar svardelning utan att förändra vad du faktiskt bedömer.
Oavsett vilka kontroller du väljer, kombinera dem med tydliga instruktioner: ange tidsgränsen, namnge de verktyg och bibliotek som är tillåtna, och säg klart och tydligt om sökmotorer är tillåtna. Otydliga regler orsakar fler legitima misslyckanden än verkligt fusk gör, och kortare, tydligt avgränsade tester tenderar att ge bättre genomförandegrad än öppna sådana.
Automatisering tar bort det manuella arbetet:
- Utlösa bedömningsinbjudningar automatiskt när en kandidat når en bestämd fas i ATS:en
- Dirigera avslutade bedömningar till en granskarkö i stället för en inkorg
- Skicka tillbaka poäng till ATS:en via en webhook så att ingen behöver skriva in resultaten manuellt
Proffstips: Testa ditt eget inbjudningsflöde som en kandidat skulle se det innan lansering. Brutna länkar och förvirrande instruktioner dödar genomförandegraden snabbare än någon knepig SQL-fråga.
Hur vet du om din bedömning faktiskt fungerar?
Spåra fyra siffror från dag ett: genomförandegrad, godkännandegrad, tid-till-anställning och sparade intervjutimmar. En godkännandegrad som aldrig rör sig, oavsett vem som söker, tyder på att ditt rubriktröskelvärde är felkalibrerat snarare än att din kandidatpool är ovanligt stark eller svag.
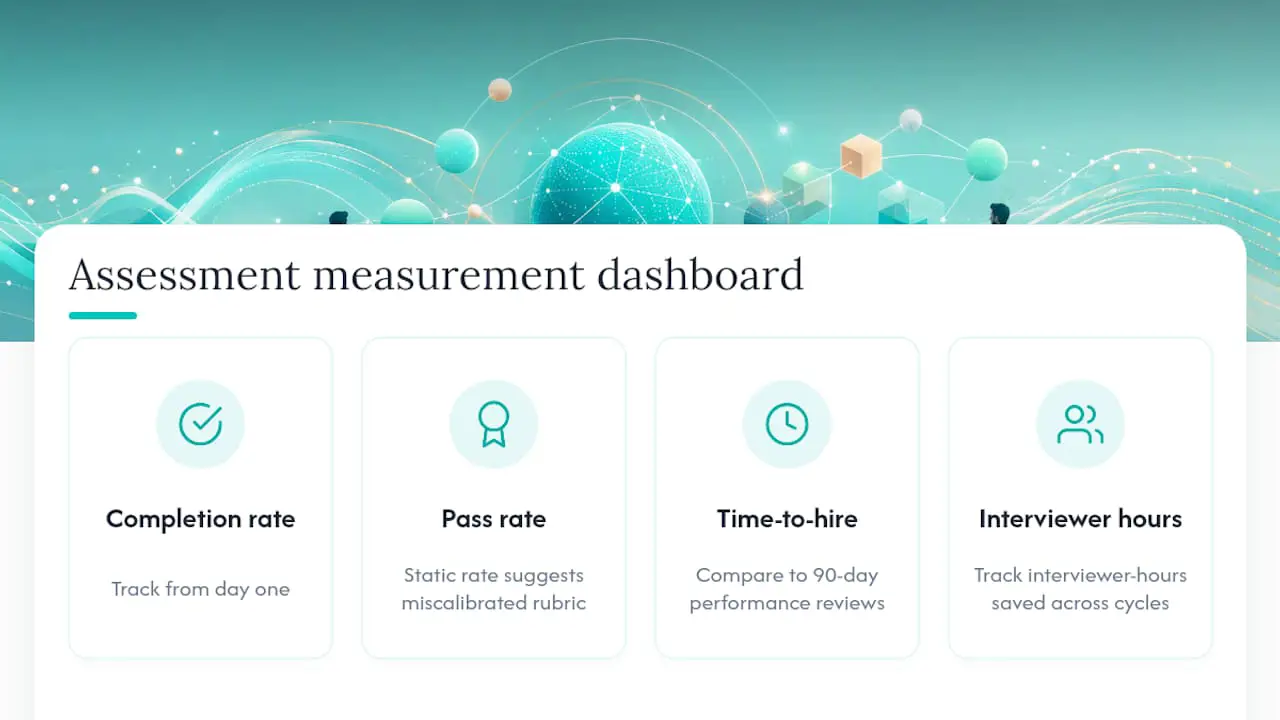
Kör ditt pilotprojekt mot en liten grupp först och jämför sedan tidiga bedömningspoäng med faktiska 90-dagarsutvärderingar när dessa anställda är på plats. Det sambandet, även från ett fåtal anställningar, berättar mer än någon teoretisk poängsättningsmodell. Att spåra genomförande, poängfördelning och tid-per-uppgift över flera omgångar låter dig också fånga upp poängdrift eller snedvridning innan det tyst påverkar vem som anställs.
Vad jag lärt mig av att bevittna dessa pilotprojekt lyckas eller misslyckas
De pilotprojekt som misslyckas delar nästan alltid en gemensam grundorsak: uppgiftslistan var för bred, eller ingen jämförde den med en riktig medarbetare innan den mötte en kandidat. Team blir entusiastiska och försöker testa sex kompetenser i en bedömning, och resultatet är en uppsvälld uppgift som tröttar ut kandidater utan att skärpa signalen. Tre fokuserade uppgifter väl poängsatta slår sex ytliga varje gång.
Den andra lärdomen är mer direkt. Triviafrågor om statistisk terminologi känns rigorösa men förutsäger nästan ingenting om huruvida någon kan rensa ett riktigt dataset under tidspress. Uppgiftsanpassning till faktiska jobbutfall är hela poängen. Använda ärligt utgör AI-genererade sammanfattningar och fuskhinder inte en ersättning för en granskares omdöme. De röjer bara undan bruset så att omdömet ägnas åt de inlämningar som faktiskt förtjänar en noggrann läsning.
— Jimmie
Bygg din bedömning utan att börja från noll
Talent Approved omvandlar arbetsflödet ovan till något du kan lansera samma eftermiddag som du läser detta. Mata in en jobbbeskrivning eller en kompetenslista i Magic Create, så genererar det en skräddarsydd, rollspecifik bedömning på minuter i stället för de dagar det vanligtvis tar att skriva uppgifter, rubriker och instruktioner från grunden.
Varje bedömning körs med inbyggda fuskhinder, inklusive skärm- och webbkameraövervakning samt sessionsuppspelning, så att du inte behöver välja mellan kandidatförtroende och resultatintegritet. AI-genererade sammanfattningar ger granskare en snabb första läsning av varje inlämning, och kandidatrangordningar omvandlar rubrikpoäng till en kortlista utan ett kalkylblad i sikte. Eftersom prissättningen är pay-as-you-go utan prenumerationsåtagande kan du testa modellen på din nästa öppna tjänst genom att besöka plattformen för aktuella detaljer. Besök Talent Approved-plattformen för att bygga din första bedömning från en befintlig jobbbeskrivning och se hur snabbt ett pilotprojekt tar form.
Vidare läsning om att bygga och skala bedömningar
- Hur bedömningar driver kandidatrangordning förklarar hur rubrikpoäng omvandlas till en användbar kortlista.
- Tekniska bedömningsformat för HR-team bryter ned formatavvägningar mer i detalj.
- Exempel på dashboards för marknadsföringsanalys erbjuder mallar värda att anpassa till uppgifter om berättande för intressenter.
Vanliga frågor
Hur lång tid ska ett test för dataanalytiker ta?
De flesta effektiva bedömningar tar totalt 45 till 90 minuter, fördelade på 2 till 3 uppgifter. Längre tester skadar vanligtvis genomförandegraden mer än de förbättrar signalen.
Vilka kompetenser ska ett test i dataanalyskunskaper faktiskt täcka?
Fokusera på datarensning, SQL-kopplingar, måttdefinition och kommunikation med intressenter. Statistikkunskaper spelar roll, men bara när de är kopplade till en uppgift som kandidaten faktiskt måste genomföra.
Ska du använda ett liveprov eller ett hemuppgiftstest?
Hemuppgiftstester fungerar bra för tidig screening eftersom de är lågtryck och lättare att skala, medan liveprover eller korta livescreeningar passar slutrundor där du vill se någon tänka i realtid.
Hur hindrar du kandidater från att fuska på ett hemuppgiftstest?
Slumpmässig variera det dataset varje kandidat får, sätt tydliga tidsgränser och använd sessionsuppspelning eller webbläsarövervakning för slutrundesbedömningar med högre insatser. Verktyg som Talent Approved bygger in dessa kontroller direkt i bedömningen.
Vad är en bra godkännandegrad för ett test för dataanalytiker?
Det finns inget universellt tal, men en grad som aldrig förändras trots väldigt olika sökandegrupper betyder vanligtvis att ditt rubriktröskelvärde behöver rekalibreras, inte att din rekryteringspool är ovanligt konsekvent.