
HR टीमों के लिए 45-90 मिनट का डेटा एनालिस्ट मूल्यांकन
सबसे अच्छा डेटा एनालिस्ट असेसमेंट वह होता है जिसमें भूमिका की वास्तविक जिम्मेदारियों से सीधे लिए गए कई जॉब टास्क शामिल होते हैं, जिन्हें एक पारदर्शी रूब्रिक पर स्कोर किया जाता है, और जिसे एक टाइमबॉक्स्ड टेक-होम या छोटी लाइव लैब के रूप में दिया जाता है। इसे किसी वास्तविक उम्मीदवार तक पहुँचाने से पहले आंतरिक रूप से पायलट करें। यह मॉडल रिज्यूमे स्क्रीन या ट्रिविया-आधारित क्विज़ की तुलना में तेज़, निष्पक्ष और अधिक भविष्यसूचक हायरिंग देता है। Talent Approved जैसे प्लेटफ़ॉर्म विशेष रूप से मैन्युअल ओवरहेड के बिना इस प्रकार के असेसमेंट को बनाने और स्कोर करने के लिए बने हैं।
TL;DR:
- असेसमेंट वास्तविक डेटा कार्यों जैसे डेटा क्लीनिंग, SQL क्वेरी लिखना, और निष्कर्ष समझाना पर स्पष्ट फोकस के साथ आयोजित करें ताकि व्यावहारिक जॉब रेडीनेस सुनिश्चित हो।
- टास्क को उचित समय दें — सरल डेटा क्लीनिंग के लिए 30 से 45 मिनट और अधिक जटिल SQL समस्याओं के लिए 60 मिनट तक, उम्मीदवार की वरिष्ठता के आधार पर समायोजन करें।
- उम्मीदवारों को विश्वसनीय रूप से रैंक करने और उचित थ्रेशोल्ड निर्धारित करने के लिए correctness, approach, interpretation, communication, और reproducibility को कवर करने वाले मल्टी-एक्सिस रूब्रिक का उपयोग करें।
- उच्च-दांव वाले असेसमेंट में चीटिंग रोकने के लिए रैंडमाइज़्ड डेटा, स्पष्ट निर्देश और एंटी-चीट टूल शामिल करें, बिना उम्मीदवार के अनुभव को नुकसान पहुँचाए।
- असेसमेंट को कैलिब्रेट करने के लिए completion, pass, और time-to-hire मेट्रिक्स नियमित रूप से ट्रैक करें, छोटे, केंद्रित कार्यों पर जोर देते हुए जो वास्तविक ऑन-द-जॉब प्रदर्शन की भविष्यवाणी करते हैं।
विषय सूची
- डेटा एनालिस्ट असेसमेंट क्या है, और इसे क्या मापना चाहिए?
- आप जॉब डिस्क्रिप्शन को टेस्टेबल टास्क में कैसे मैप करते हैं?
- डेटा एनालिस्ट भूमिका के लिए कौन सा असेसमेंट फॉर्मेट उपयुक्त है?
- आप उम्मीदवारों को निष्पक्ष रूप से कैसे स्कोर और रैंक करें?
- उम्मीदवार के अनुभव को नुकसान पहुँचाए बिना चीटिंग कैसे रोकें?
- आप कैसे जानें कि आपका असेसमेंट वास्तव में काम कर रहा है?
- इन पायलट्स को सफल या विफल होते देखकर मैंने क्या सीखा
- बिना शून्य से शुरू किए अपना असेसमेंट बनाएं
- असेसमेंट बनाने और स्केल करने पर आगे पढ़ें
- FAQ
डेटा एनालिस्ट असेसमेंट क्या है, और इसे क्या मापना चाहिए?
डेटा एनालिस्ट असेसमेंट एक संरचित परीक्षण है जो यह मापता है कि उम्मीदवार वास्तव में काम कर सकता है या नहीं: गंदे डेटा को साफ करना, काम करने वाली SQL लिखना, परिणामों की व्याख्या करना, और निष्कर्ष ऐसे किसी को समझाना जो जीविका के लिए स्प्रेडशीट नहीं छूता। यह जॉब सीकर्स के लिए खुद के समय पर अभ्यास करने के लिए बने डेटा एनालिसिस स्किल्स टेस्ट से अलग है। यह एक ऐसा टूल है जिसे HR टीमें और हायरिंग मैनेजर बनाते और नियंत्रित करते हैं, जो एक विशिष्ट जॉब डिस्क्रिप्शन से जुड़ा होता है और आपकी टीम द्वारा परिभाषित रूब्रिक के आधार पर स्कोर किया जाता है।
अधिकांश हायरिंग टीमें जो गलती करती हैं वह है टास्क की जगह ज्ञान का परीक्षण करना। एक उम्मीदवार जो "median absolute deviation" की परिभाषा याद से बता सकता है, वह तब भी अटक सकता है जब उसे डुप्लीकेट पंक्तियों और असंगत डेट फॉर्मेट से भरी स्प्रेडशीट दी जाए। इसका समाधान रिज्यूमे नहीं, बल्कि भूमिका को मैप करने से शुरू होता है।
आप जॉब डिस्क्रिप्शन को टेस्टेबल टास्क में कैसे मैप करते हैं?
जॉब डिस्क्रिप्शन से सीधे कई मुख्य, अवलोकन योग्य टास्क निकालकर शुरू करें। यह जॉब-टास्क एनालिसिस पूरे असेसमेंट की नींव है, और इसे छोड़ना वह सबसे बड़ा कारण है जिससे असेसमेंट प्रदर्शन की भविष्यवाणी करने में विफल होते हैं। एंटरप्राइज़ हायरिंग गाइड के अनुसार जो इस संबंध को ट्रैक करती हैं, जॉब डिस्क्रिप्शन से सीधे टेस्ट आइटम बनाना लगातार इस बात में सुधार करता है कि असेसमेंट ऑन-द-जॉब परिणामों की भविष्यवाणी कितनी अच्छी तरह करता है।
एक सामान्य डेटा एनालिस्ट भूमिका के लिए, वह टास्क सूची आमतौर पर इस प्रकार दिखती है:
- मिसिंग वैल्यू, डुप्लीकेट, या असंगत फॉर्मेटिंग वाले डेटासेट को साफ करना
- दो या तीन संबंधित टेबल में SQL जॉइन लिखना
- किसी मेट्रिक को इतनी स्पष्टता से परिभाषित करना कि दो लोग उसे एक ही तरह से कैलकुलेट करें
- एक चार्ट या संक्षिप्त नैरेटिव बनाना जो किसी गैर-तकनीकी स्टेकहोल्डर को एक निष्कर्ष समझाए
- किसी और के एनालिसिस में कोई त्रुटि या आउटलायर पहचानना
वरिष्ठता मानक बदलती है, टास्क सूची नहीं। एंट्री-लेवल उम्मीदवार को एक साफ टेबल और 45 मिनट मिल सकते हैं। सीनियर एनालिस्ट उम्मीदवार को तीन गंदी, ढीली तरह से संबंधित टेबल, अस्पष्ट आवश्यकताएं, और 90 मिनट मिलते हैं — क्योंकि आप आंशिक रूप से यह भी परख रहे होते हैं कि वे अस्पष्टता को कैसे संभालते हैं।
इस असेसमेंट को किसी वास्तविक उम्मीदवार से मिलाने से पहले, इसे अपनी एनालिटिक्स टीम के दो या तीन मौजूदा कर्मचारियों के साथ चलाएं। उनके स्कोर आपका बेंचमार्क बन जाते हैं, और उनकी प्रतिक्रिया आपको बताती है कि टास्क में 45 मिनट लगते हैं या गुप्त रूप से दो घंटे।
प्रो टिप: यदि आपके अपने एनालिस्ट आपके आवंटित समय में टास्क पूरा नहीं कर सकते, तो कोई भी उम्मीदवार नहीं कर पाएगा। उम्मीदवारों से अपनी अपेक्षाएं बदलने से पहले घड़ी समायोजित करें।
डेटा एनालिस्ट भूमिका के लिए कौन सा असेसमेंट फॉर्मेट उपयुक्त है?
फॉर्मेट तय करता है कि आपको कितना सिग्नल मिलता है और उम्मीदवार को कितना घर्षण महसूस होता है। एक छोटी लाइव स्क्रीन तेज़ होती है और नकली बनाना मुश्किल होता है, लेकिन यह केवल सतही स्तर की प्रवाहिता दर्शाती है। एक टाइम्ड टेक-होम कम दबाव में वास्तविक समस्या-समाधान दिखाता है, लेकिन यह बाहरी सहायता के प्रति अधिक संवेदनशील है। सैंडबॉक्स्ड डेटासेट के साथ हैंड्स-ऑन लैब बीच में है: यथार्थवादी, गेम करना कठिन, और फिर भी उम्मीदवार के समय का सम्मान करने वाला। फॉर्मेट का चुनाव लगातार फिडेलिटी बनाम उम्मीदवार का बोझ और चीटिंग के जोखिम के बीच व्यापार करता है, और छोटे, अधिक प्रासंगिक टास्क लंबे, सामान्य टास्क की तुलना में क्लीनर completion डेटा देते हैं।
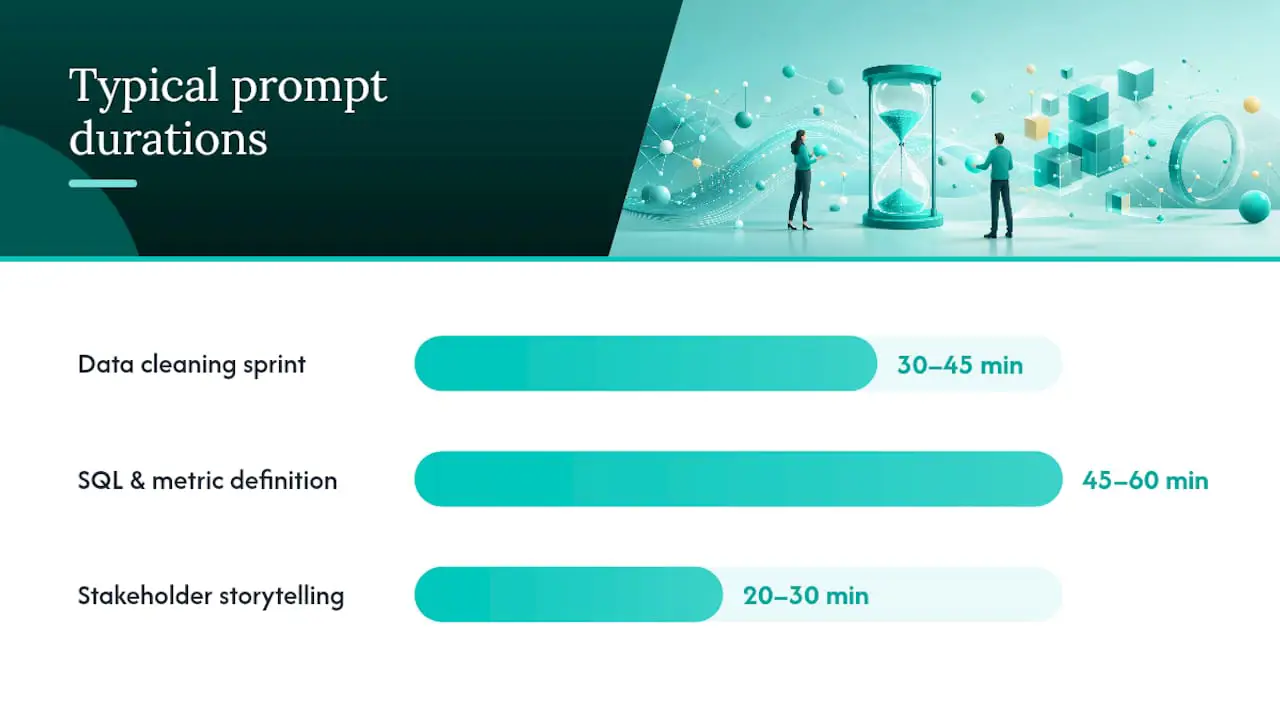
तीन प्रॉम्प्ट जो अधिकांश डेटा एनालिस्ट हायर के लिए अच्छी तरह काम करते हैं:
- डेटा क्लीनिंग स्प्रिंट (30 से 45 मिनट)। डुप्लीकेट पंक्तियों, असंगत डेट फॉर्मेट और कुछ null वैल्यू के साथ एक रॉ CSV दें। उम्मीदवार से एक साफ डेटासेट और साथ में एक छोटी सूची मांगें जिसमें वे बताएं कि उन्होंने क्या ठीक किया और क्यों।
- SQL और मेट्रिक डेफिनिशन (45 से 60 मिनट)। दो संबंधित टेबल प्रदान करें और एक विशिष्ट बिज़नेस प्रश्न का उत्तर देने वाली क्वेरी के साथ-साथ उनके द्वारा कैलकुलेट किए गए मेट्रिक की लिखित परिभाषा मांगें।
- स्टेकहोल्डर स्टोरीटेलिंग (20 से 30 मिनट, लाइव या रिकॉर्डेड)। एक तैयार चार्ट या सारांश टेबल सौंपें और उम्मीदवार से इसे तीन मिनट से कम में एक काल्पनिक मार्केटिंग डायरेक्टर को समझाने के लिए कहें।
टेक-होम डेटा में कुछ यथार्थवादी विशेषताएं शामिल करें, जैसे टेक्स्ट के साथ मिश्रित करेंसी फील्ड, ताकि टास्क किसी पहेली की बजाय ऑफिस में वास्तविक मंगलवार जैसा लगे।
आप उम्मीदवारों को निष्पक्ष रूप से कैसे स्कोर और रैंक करें?
प्रत्येक सबमिशन को एकल pass या fail टॉगल के बजाय चार या पांच अक्षों के साथ एक भारित रूब्रिक के आधार पर स्कोर करें। मल्टी-एक्सिस रूब्रिक सिंगल-स्कोर ग्रेडिंग की तुलना में अधिक विश्वसनीय रैंकिंग देता है क्योंकि यह समीक्षकों को "सही नंबर मिला" और "सही तरीके से पहुंचा" को अलग करने के लिए मजबूर करता है।
डेटा एनालिस्ट असेसमेंट के लिए एक ठोस रूब्रिक आमतौर पर इन्हें कवर करता है:
- Correctness — क्या आउटपुट अपेक्षित परिणाम से मेल खाता था, और न मेल खाने पर यह कितना करीब था?
- Approach — क्या उम्मीदवार ने एक उचित तरीका चुना, या वे भाग्यशाली रहे?
- Interpretation — क्या उन्होंने अपने आउटपुट से सही निष्कर्ष निकाला?
- Communication — क्या कोई गैर-एनालिस्ट उनकी व्याख्या समझ सकता था?
- Reproducibility — क्या कोई अन्य एनालिस्ट उनके चरणों को फिर से चलाकर वही उत्तर प्राप्त कर सकता था?
जूनियर भूमिकाओं के लिए correctness और approach को सबसे अधिक वजन दें, और वरिष्ठता बढ़ने के साथ वजन interpretation और communication की ओर स्थानांतरित करें। "इंटरव्यू के लिए आगे बढ़ें" का थ्रेशोल्ड एक मनमाने गोल नंबर पर नहीं, बल्कि अपने पायलट बेंचमार्क स्कोर पर सेट करें।
AI-जनरेटेड सारांश किसी मानव द्वारा लाइन-बाय-लाइन पढ़ने से पहले मजबूत और कमजोर सबमिशन को फ्लैग करके समीक्षा को तेज कर सकते हैं, लेकिन वे दूसरी राय के रूप में सबसे अच्छा काम करते हैं। जो समीक्षक वास्तविक काम कभी नहीं खोलता वह उम्मीदवार का नहीं, सारांश का मूल्यांकन कर रहा है। असेसमेंट एनालिटिक्स जो completion और pass वितरण को ट्रैक करता है यह जांचने में मदद करता है कि आपकी रूब्रिक वेटिंग वास्तव में समय के साथ मजबूत उम्मीदवारों को कमजोरों से अलग कर रही है या नहीं।
उम्मीदवार के अनुभव को नुकसान पहुँचाए बिना चीटिंग कैसे रोकें?
एंटी-चीट नियंत्रण भूमिका के दांव से मेल खाने चाहिए, न कि संदेह को अधिकतम करने के लिए। एक जूनियर स्क्रीन को केवल रैंडमाइज़्ड डेटासेट सीड्स की आवश्यकता हो सकती है। सीनियर एनालिस्ट भूमिका के लिए फाइनल-राउंड असेसमेंट में सेशन रिप्ले या ब्राउज़र लॉकडाउन उचित हो सकता है। प्रत्येक उम्मीदवार को प्राप्त डेटा को रैंडमाइज़ करने से उत्तर-साझाकरण में कमी आती है, बिना यह बदले कि आप वास्तव में क्या ग्रेड कर रहे हैं।
आप जो भी नियंत्रण चुनें, उन्हें स्पष्ट निर्देशों के साथ जोड़ें: समय सीमा बताएं, वे टूल और लाइब्रेरी बताएं जो उपयोग करना उचित है, और स्पष्ट रूप से कहें कि सर्च इंजन की अनुमति है या नहीं। अस्पष्ट नियमों से वास्तविक चीटिंग से अधिक वैध विफलताएं होती हैं, और छोटे, स्पष्ट रूप से परिभाषित टेस्ट ओपन-एंडेड की तुलना में बेहतर completion दर देते हैं।
ऑटोमेशन मैन्युअल काम को हटाता है:
- किसी उम्मीदवार के एक निर्धारित ATS चरण तक पहुंचने पर असेसमेंट इनवाइट स्वचालित रूप से ट्रिगर करें
- पूर्ण असेसमेंट को इनबॉक्स की बजाय रिव्यूअर क्यू में भेजें
- वेबहुक के माध्यम से स्कोर वापस ATS में पुश करें ताकि कोई परिणाम दोबारा टाइप न करे
प्रो टिप: लॉन्च से पहले अपने खुद के इनवाइट फ्लो को उम्मीदवार की तरह टेस्ट करें। टूटे हुए लिंक और भ्रामक निर्देश completion दर को किसी भी कठिन SQL प्रश्न से तेज़ी से खत्म कर देते हैं।
आप कैसे जानें कि आपका असेसमेंट वास्तव में काम कर रहा है?
पहले दिन से चार संख्याएं ट्रैक करें: completion rate, pass rate, time-to-hire, और interviewer-hours saved। एक pass rate जो कभी नहीं बदलती, चाहे कोई भी आवेदन करे, यह सुझाव देती है कि आपका रूब्रिक थ्रेशोल्ड गलत तरह से कैलिब्रेट है, न कि आपके उम्मीदवार पूल का असामान्य रूप से मजबूत या कमजोर होना।
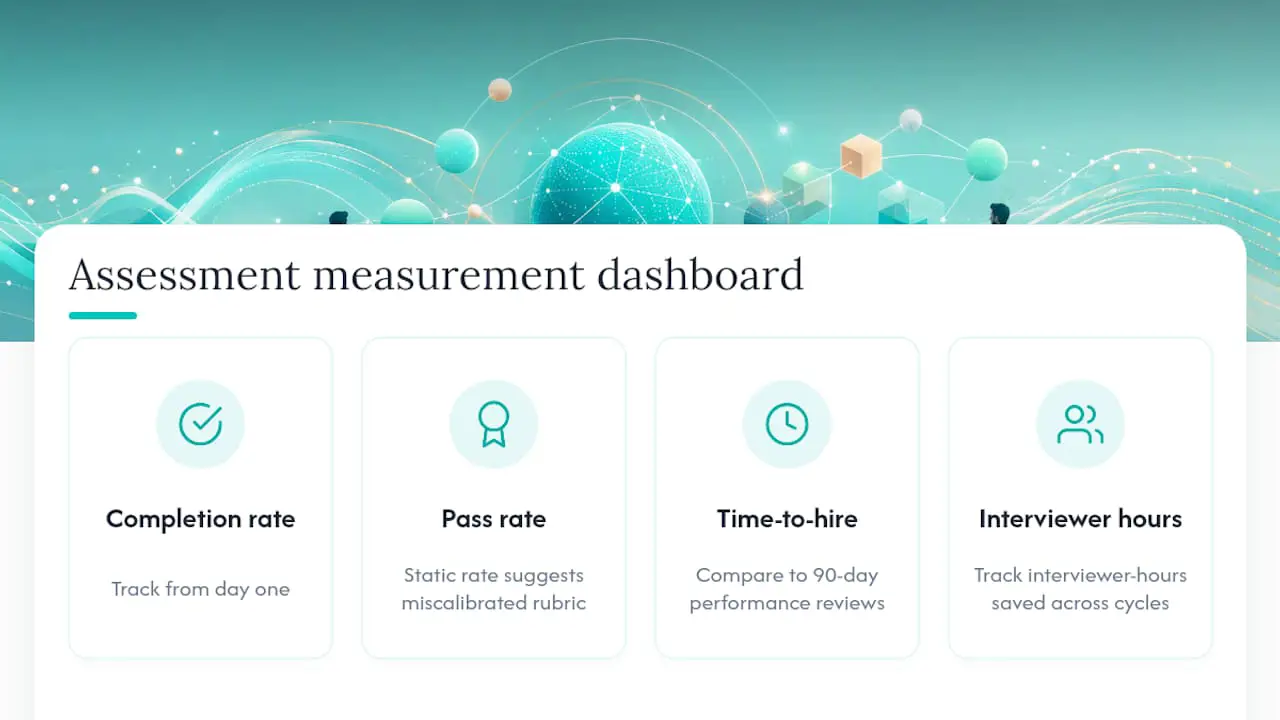
अपना पायलट पहले एक छोटे समूह के खिलाफ चलाएं, फिर एक बार वे हायर नौकरी पर आ जाएं तो प्रारंभिक असेसमेंट स्कोर की तुलना वास्तविक 90-दिन के परफॉर्मेंस रिव्यू से करें। यह सहसंबंध, यहां तक कि कुछ मुट्ठी भर हायर से भी, किसी भी सैद्धांतिक स्कोरिंग मॉडल से अधिक बताता है। कई चक्रों में completion, pass वितरण, और time-on-task ट्रैक करने से आप स्कोर ड्रिफ्ट या बायस को उससे पहले पकड़ सकते हैं जब यह चुपचाप यह तय करने लगे कि कौन हायर होता है।
इन पायलट्स को सफल या विफल होते देखकर मैंने क्या सीखा
जो पायलट विफल होते हैं वे लगभग हमेशा एक मूल कारण साझा करते हैं: टास्क सूची बहुत व्यापक थी, या किसी ने उम्मीदवार से मिलने से पहले इसे किसी वास्तविक कर्मचारी के खिलाफ बेंचमार्क नहीं किया। टीमें उत्साहित होती हैं और एक असेसमेंट में छह योग्यताओं का परीक्षण करने की कोशिश करती हैं, और परिणाम एक फूला हुआ टास्क होता है जो उम्मीदवारों को थका देता है बिना सिग्नल को तेज किए। अच्छी तरह से स्कोर किए गए तीन केंद्रित टास्क हर बार छह उथले टास्क से बेहतर होते हैं।
दूसरा सबक और भी स्पष्ट है। सांख्यिकीय शब्दावली के बारे में ट्रिविया प्रश्न कठोर लगते हैं लेकिन इस बारे में लगभग कुछ भी नहीं बताते कि कोई डेडलाइन के तहत वास्तविक डेटासेट को साफ कर सकता है या नहीं। वास्तविक जॉब परिणामों के साथ टास्क का संरेखण ही पूरा खेल है। ईमानदारी से उपयोग किए जाने पर, AI-जनरेटेड सारांश और एंटी-चीट टूलिंग किसी समीक्षक के निर्णय की जगह नहीं लेते। वे बस शोर को दूर करते हैं ताकि वह निर्णय उन सबमिशन पर खर्च हो जो वास्तव में गहन पढ़ाई के लायक हैं।
— Jimmie
बिना शून्य से शुरू किए अपना असेसमेंट बनाएं
Talent Approved ऊपर दिए गए वर्कफ्लो को कुछ ऐसा बना देता है जिसे आप उसी दोपहर लॉन्च कर सकते हैं जिस दिन आप इसे पढ़ते हैं। Magic Create में एक जॉब डिस्क्रिप्शन या स्किल सूची फीड करें, और यह मिनटों में एक अनुकूलित, भूमिका-विशिष्ट असेसमेंट तैयार करता है, बजाय उन दिनों के जो आमतौर पर टास्क, रूब्रिक और निर्देश शुरू से लिखने में लगते हैं।
प्रत्येक असेसमेंट बिल्ट-इन एंटी-चीट नियंत्रणों के साथ चलता है, जिसमें स्क्रीन और वेबकैम मॉनिटरिंग और सेशन रिप्ले शामिल हैं, इसलिए आपको उम्मीदवार के विश्वास और परिणाम की ईमानदारी के बीच चुनाव नहीं करना पड़ता। AI-जनरेटेड सारांश समीक्षकों को प्रत्येक सबमिशन पर तेज पहली पढ़ाई देते हैं, और उम्मीदवार रैंकिंग रूब्रिक स्कोर को बिना किसी स्प्रेडशीट के एक शॉर्टलिस्ट में बदल देती है। चूंकि मूल्य निर्धारण बिना किसी सब्सक्रिप्शन प्रतिबद्धता के pay-as-you-go आधार पर चलता है, आप वर्तमान विवरण के लिए प्लेटफ़ॉर्म पर जाकर अपने अगले खुले रेक पर मॉडल का परीक्षण कर सकते हैं। अपने पहले असेसमेंट को मौजूदा जॉब डिस्क्रिप्शन से बनाने और यह देखने के लिए कि पायलट कितनी जल्दी एक साथ आता है, Talent Approved प्लेटफ़ॉर्म पर जाएं।
असेसमेंट बनाने और स्केल करने पर आगे पढ़ें
- असेसमेंट उम्मीदवार रैंकिंग को कैसे चलाते हैं यह बताता है कि रूब्रिक स्कोर एक उपयोगी शॉर्टलिस्ट में कैसे बदलते हैं।
- HR टीमों के लिए तकनीकी असेसमेंट फॉर्मेट फॉर्मेट के ट्रेड-ऑफ को अधिक विस्तार से बताता है।
- मार्केटिंग एनालिटिक्स डैशबोर्ड उदाहरण ऐसे टेम्पलेट प्रदान करते हैं जिन्हें स्टेकहोल्डर-स्टोरीटेलिंग प्रॉम्प्ट में अनुकूलित करने लायक हैं।
FAQ
डेटा एनालिस्ट असेसमेंट में कितना समय लगना चाहिए?
अधिकांश प्रभावी असेसमेंट कुल 45 से 90 मिनट, 2 से 3 टास्क में विभाजित होकर चलते हैं। लंबे टेस्ट आमतौर पर सिग्नल सुधारने से अधिक completion दर को नुकसान पहुंचाते हैं।
डेटा एनालिस्ट स्किल्स टेस्ट में वास्तव में कौन से कौशल शामिल होने चाहिए?
डेटा क्लीनिंग, SQL जॉइन, मेट्रिक डेफिनिशन, और स्टेकहोल्डर कम्युनिकेशन पर ध्यान दें। सांख्यिकी ज्ञान मायने रखता है, लेकिन केवल तब जब वह किसी ऐसे टास्क से जुड़ा हो जिसे उम्मीदवार को वास्तव में पूरा करना हो।
क्या आपको लाइव लैब या टेक-होम टेस्ट का उपयोग करना चाहिए?
टेक-होम शुरुआती स्क्रीनिंग के लिए अच्छी तरह काम करते हैं क्योंकि वे कम दबाव वाले और स्केल करने में आसान होते हैं, जबकि लाइव लैब या छोटी लाइव स्क्रीन फाइनल राउंड के लिए उपयुक्त होती हैं जहाँ आप किसी को रियल टाइम में सोचते देखना चाहते हैं।
टेक-होम पर उम्मीदवारों को चीटिंग से कैसे रोकें?
प्रत्येक उम्मीदवार को मिलने वाले डेटासेट को रैंडमाइज़ करें, स्पष्ट समय सीमाएं निर्धारित करें, और उच्च-दांव वाले फाइनल राउंड के लिए सेशन रिप्ले या ब्राउज़र मॉनिटरिंग का उपयोग करें। Talent Approved जैसे टूल इन नियंत्रणों को सीधे असेसमेंट में बनाते हैं।
डेटा एनालिस्ट असेसमेंट के लिए एक अच्छी pass rate क्या है?
कोई सार्वभौमिक संख्या नहीं है, लेकिन एक दर जो बहुत अलग-अलग आवेदक पूल में कभी नहीं बदलती, आमतौर पर इसका मतलब है कि आपके रूब्रिक थ्रेशोल्ड को पुनः कैलिब्रेशन की आवश्यकता है, न कि यह कि आपका हायरिंग पूल असामान्य रूप से सुसंगत है।