
Rekrutterere: Ettside-maler for prestasjonsvurdering og AI-prompter
Samlet egnethet: Sterk — kandidaten besto alle kjernetekniske dimensjoner med koblet dokumentasjon og ingen integritetsmerknader. Den ene linjen med konklusjon, støttet av en setning med begrunnelse knyttet til rollekritsik dokumentasjon, er det en brukbar ytelsesoppsummering alltid innleder med. Alt annet, fra styrkepunkter til rubrikkscore, støtter opp under denne innledende vurderingen fremfor å begrave den.
TL;DR:
- Kandidater som består alle kjernetekniske sjekker, viser typisk konsekvent, fullt testet arbeid uten integritetsmerknader, noe som støtter konklusjonen om sterk egnethet.
- Dokumentasjon for styrker bør være spesifikk, tidsstemplet eller sitert, mens mangler eller bekymringer identifiseres ved eksakte øyeblikk eller innleveringer som avslører svakheter.
- Vurderingsscorer er relative intervaller; en score nær grenseverdien krever manuell gjennomgang av dokumentasjon fremfor automatisk avvisning.
- En ensidig oppsummering, med konklusjonen først og punkter begrenset til tre til fem for styrker og bekymringer, fremmer raskere og tydeligere beslutningstaking.
- Menneskelig gjennomgang er avgjørende for grenseverdiscorer, med eksplisitt merking av faktabaserte kontra slutte egenskaper og dokumentasjon av scoreoverstyringer for revisjonsformål.
Innholdsfortegnelse
- Hvordan ser eksempler på ytelsesoppsummeringer ut i praksis?
- Hvordan skriver du en ytelsesoppsummering som paneler faktisk leser?
- Hvordan bør du presentere rubrikkscore og scoreintervaller?
- Når bør du overstyre en AI-generert score?
- Hvordan Talent Approved bygger dette inn i gjennomgangsprosessen
- Et praktisk notat fra feltet
- Prøv malarbeidsflyten uten å bygge den selv
- Kilder
- FAQ
Hvordan ser eksempler på ytelsesoppsummeringer ut i praksis?
En ytelsesoppsummering er ikke et transskript, og det er ikke et dashbordskjermbilde. Det er et komprimert, beslutningsklart dokument som setter konklusjonen først og støtter den med akkurat nok dokumentasjon til å forsvare vurderingen. Rapporter bygget på denne måten plasserer egnethetskonklusjonen øverst og begrenser styrker og bekymringer til 3 til 5 punkter hver, med ett støttesitat eller én dokumentasjonslinje per punkt.
Her er hvordan dette ser ut for tre vanlige utfall rekrutterere trenger å kommunisere: ansett, mulig og sett på vent.
Mal for ansett eller finalist
- Konklusjon: Egnethet: Sterk. Én setning som knytter vurderingen til den mest rollekritiske dokumentasjonen (eksempel: «Besto alle kontroller for backend-arkitektur med ren, testet kode på første forsøk»).
- Styrker (3 punkter, én dokumentasjonslinje hver): Spesifikk ferdighet, oppgave eller svar som beviser det. Tidsstempel eller utdragsreferanse der det er relevant.
- Bekymringer (2 punkter, én dokumentasjonslinje hver): Navngitt mangel, med det eksakte øyeblikket eller innleveringen som avslørte den.
- Dimensjonsoversikt: Én setning per rubrikk-rad (se neste avsnitt for format).
- Integritetsnotat: Ren økt, eller merknad med detaljer.
- Neste steg: Planlegg panelets runde, eller gå videre til tilbudsstadiet.
Mal for mulig
- Konklusjon: Egnethet: Mulig, betinget av [spesifikk mangel].
- 3 til 4 punkter som dekker hva som fungerte, hver med én dokumentasjonslinje.
- 2 punkter som navngir mangelen og foreslår en oppfølging, for eksempel en målrettet ny test eller en 20-minutters teknisk oppfølgingssamtale.
- Dimensjonsoversikt med den grenseverdige raden eksplisitt flagget.
Mal for sett på vent eller ikke anbefalt
- Konklusjon: Egnethet: Ikke anbefalt for denne rollen, uttrykt tydelig og uten å tillegge noe.
- 3 punkter om hva kandidaten gjorde bra, slik at registreringen forblir rettferdig.
- 2 til 3 punkter om de spesifikke manglene som drev beslutningen, hver med dokumentasjon.
- Én linje om kandidaten passer til en annen åpen stilling.
Alle versjoner holder seg til de samme begrensningene: én linjes konklusjon, 3 til 5 punkter per kategori, én setning per dimensjon. Den disiplinen er det som gjør at et panel med fem gjennomgangspersoner leser det samme dokumentet på samme måte.
Hvordan skriver du en ytelsesoppsummering som paneler faktisk leser?
De fleste oppsummeringer mislykkes av én grunn: de ble skrevet for å dokumentere innsats, ikke for å drive en beslutning. Å rette opp dette starter før kandidaten i det hele tatt er ferdig med vurderingen.
- Fastsett beslutningsdimensjonene med ansettelsesansvarlig først. Bli enige om 4 til 6 rubrikk-rader (teknisk nøyaktighet, kommunikasjon, problemløsning, hva som enn er viktig for rollen) før resultatene kommer inn. Faste dimensjoner gjør kandidater sammenlignbare, og en rubrikk som endres underveis ødelegger dette.
- Samle dokumentasjon per dimensjon underveis. Et sitat, et tidsstempel, et kodeeksempel, et utdrag fra en innlevering. Vage inntrykk overlever ikke en panelutfordring.
- Instruer AI-en med et eksakt promptmønster. Spesifiser utdataformatet, begrens punkter til 5, krev én dokumentasjonslinje per påstand, og instruer den til å merke enhver sluttet egenskap (for eksempel «sannsynligvis samarbeidende») separat fra angitte fakta (for eksempel «ledet et team på fire»).
- Håndhev lengdedisiplin. Én side. Begrensede punkter. Én setning per dimensjonsnotat. Dette er den ene vanen som skiller et dokument en ansettelsesansvarlig leser på nitti sekunder fra ett som skummes og ignoreres.
- Legg til en integritetsoppsummering med lenke til detaljer. Én enkelt linje («Ingen merknader, fullstendig økt er registrert») tilfredsstiller de fleste gjennomgangspersoner; lenk til den fullstendige øktloggen for de som ønsker å sjekke.
Proffstips: Bygg AI-prompten din én gang, lagre den som en mal, og gjenbruk den på tvers av alle roller. Konsistens på tvers av oppsummeringer betyr mer enn å perfeksjonere én enkelt.
Hvordan bør du presentere rubrikkscore og scoreintervaller?
Hver dimensjons-rad trenger fire ting: etiketten, vurderingen, én linjes dokumentasjon og en merknad om vurderingen er angitt eller sluttet. Hopper du over merknaden, inviterer du et panel til å behandle en gjetning som et faktum.
En generisk 4-punkts rubrikk-rad kan se slik ut:
| Dimensjon | Vurdering | Dokumentasjon | Grunnlag |
|---|---|---|---|
| Teknisk nøyaktighet | Sterk | Besto alle 4 testtilfeller ved første innlevering | Angitt |
| Kommunikasjon | Gjennomsnittlig | Tydelig forklaring av logikk, noe nøling under tidspress | Angitt |
| Problemløsning | Sterk | Valgte den mest effektive av to gyldige tilnærminger uten oppfordring | Angitt |
| Kulturtilpassingssignaler | Gjennomsnittlig | Svar antyder samarbeidende stil, ikke direkte testet | Sluttet |
Score er intervaller, ikke konklusjoner i seg selv. Vurderingsresultater er relative og inneholder målefeil, noe som betyr at de bør leses opp mot rollespesifikke normer fremfor å behandles som harde grenseverdier. En kandidat som scorer rett under en terskel fortjener en ny gjennomgang fremfor automatisk avvisning, særlig på en dimensjon med lite dokumentasjon bak seg.
- Presenter den vektede totalen én gang, nær konklusjonen, ikke spredt utover siden.
- Vis regnestykket per dimensjon bare hvis en gjennomgangsperson ber om det; selve oppsummeringen bør holde seg på én side.
- Merk enhver dimensjon der scoren ligger innenfor noen få poeng av grenseverdien din som «nær terskel» slik at gjennomgangspersonene vet at de bør lese dokumentasjonslinjen fremfor å stole på tallet alene.
Når bør du overstyre en AI-generert score?
AI-autoscoringsverktøy viser vanligvis utvidbare stjerneoppdelinger og skriftlige begrunnelser som en gjennomgangsperson kan åpne før de godtar en etikett. Behandle den begrunnelsen som det første du sjekker, ikke selve scoren.
- Sjekk dokumentasjonslenken først. Åpne det koblede transskriptet, kodeeksempelet eller videoutdraget bak scoren. Hvis begrunnelsen ikke stemmer overens med det du ser, er det din overstyringstrigg.
- Sjekk integritetsmerknader. Enhver merknad endrer hvor mye vekt scoren fortjener, uavhengig av tallet knyttet til den.
- Overstyr på regelnivå. De fleste plattformer lar deg snu en spesifikk regel eller justere en stjernvurdering, og den vektede totalen beregnes automatisk på nytt når du gjør det.
- Eskaler grensetilfeller. Hvis en kandidat ligger innenfor omtrent ett poeng av grenseverdien din på en rollekritisk dimensjon, send det til et panel eller be om en kort menneskelig ny test fremfor å stole på én automatisert score.
- Loggfør endringen. Registrer hvem som overstyret scoren, hvorfor, og den nye vektede totalen. Det revisjonssporet er det som beskytter beslutningen senere.
Statistikkfremhevning: En score nær terskelen er en gjennomgangsutløser, ikke en avvisning. Behandle enhver dimensjonsscore innenfor et smalt band av grenseverdien din som et signal om å sjekke dokumentasjonslinjen selv, siden vurderingsresultater inneholder målefeil av design.
Hvordan Talent Approved bygger dette inn i gjennomgangsprosessen
Alle malene og sjekklistene ovenfor kartlegges direkte til funksjoner bygget inn i Talent Approved-plattformen. Magic Create genererer den rollespesifikke rubrikken på minutter fra en stillingsbeskrivelse, slik at dimensjonene er fastsatt før den første kandidaten er ferdig med testingen. Den AI-genererte oppsummeringen som kommer ut på den andre siden, følger den samme disiplinen: konklusjon øverst, dokumentasjonskoblede vurderinger og et ensides oppsett fremfor et rådatadump.
- Strukturerte rubrikker erstatter ad hoc-scoring med konsistente, sammenlignbare dimensjoner på tvers av alle kandidater. Se plattformens sjekkliste for kandidatevalueringskriterier for hvordan disse dimensjonene defineres.
- Anti-juksovervåking, inkludert skjerm- og webkamerakontroller, mater integritetsnotatet direkte inn i oppsummeringen.
- Øktavspillinger og dokumentasjonslenker lar en gjennomgangsperson verifisere en vurdering på sekunder — den samme overstyringsprosessen som er beskrevet ovenfor.
- Kandidatrangeringer bringer de vektede totalene videre slik at et panel kan sammenligne finalister uten å måtte bygge om et poengsystem for hånd. Les om hvordan rask kandidatevaluering fungerer for rekrutterere for en nærmere titt på mekanikken.
Et praktisk notat fra feltet
Tre feil ødelegger de fleste ytelsesoppsummeringer: å endre rubrikk-dimensjoner mellom kandidater, å skrive rapporter lange nok til å begrave konklusjonen, og å behandle en AI-score som endelig i stedet for et utgangspunkt for gjennomgang.
Tre løsninger virker raskt. Begrens hver oppsummering til én side. Plasser konklusjonen på første linje, alltid. Og krev en menneskelig sjekk på enhver score som ligger nær grenseverdien din før den avgjør noens utfall. Prøv disse malene på din neste kandidatliste før din neste fulle ansettelsesrunde. Du vil merke forskjellen i hvor raskt panelet ditt faktisk blir enig.
— Jimmie
Prøv malarbeidsflyten uten å bygge den selv
Plattformen gjør alt i denne guiden til noe du ikke trenger å bygge for hånd. Den kan skrive en rubrikk fra en stillingsbeskrivelse, samle integritetsnotater automatisk og produsere en AI-generert oppsummering med konklusjon først og dokumentasjonslenker slik som beskrevet.
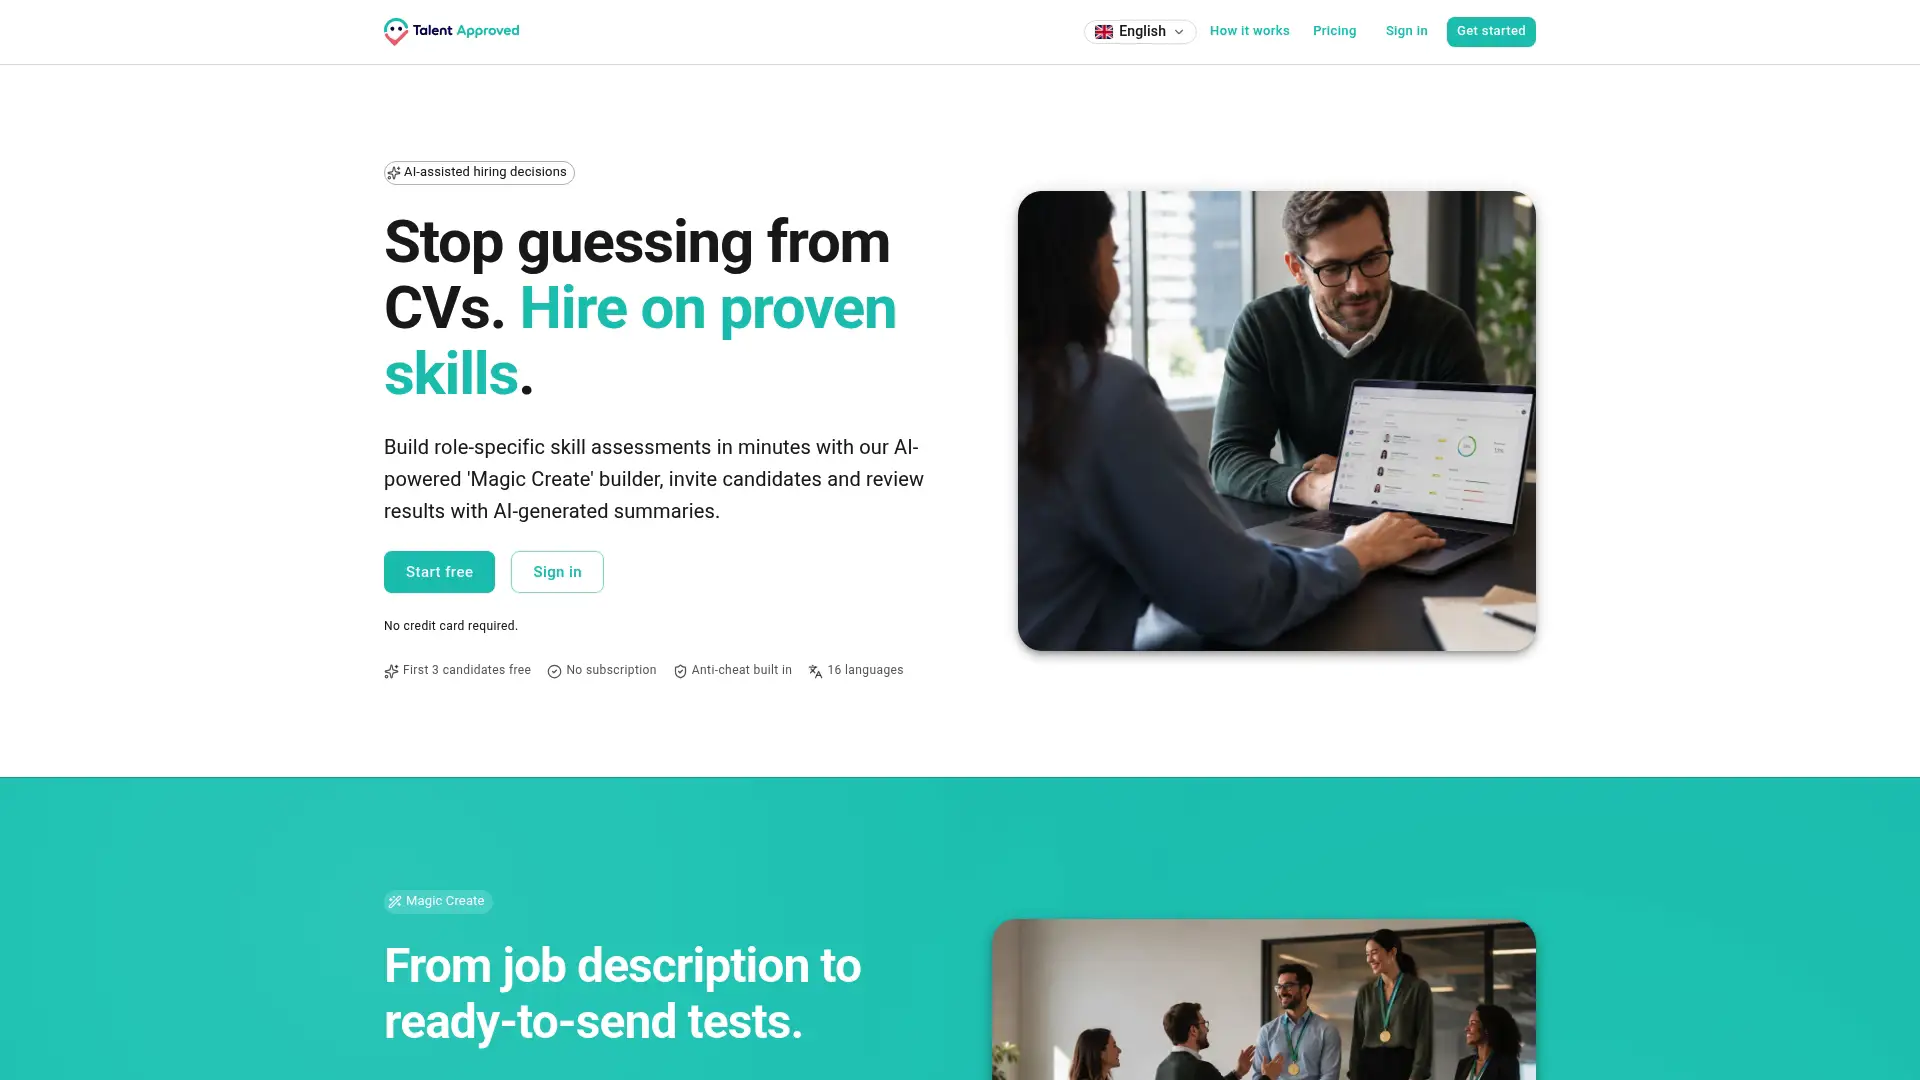
Det er ikke nødvendig å forplikte seg til et abonnement først. Talent Approved kjører på en betal-etter-bruk-modell: $5 per kandidat som fullfører en vurdering, med detaljer på prissiden. Kjør én rolle gjennom det, sammenlign oppsummeringen du får med malene ovenfor, og bestem derfra om det passer din ansettelsesarbeidsflyt.
Kilder
- Sharing Interview Results With Hiring Stakeholders: PDF Reports Done Right | ClarityHire
- Skill
- How Do You Review AI Auto-Scoring Results in Canditech? | Canditech Help Center
- A Step-by-Step Guide to Interpreting Skill Assessment Results | Riot IQ
FAQ
Hva er den ideelle lengden på en kandidatytelsesoppsummering?
Én side, med styrker og bekymringer begrenset til 3 til 5 punkter hver og én setning per rubrikk-dimensjon. Denne lengden tvinger frem dokumentasjonsstøttet, beslutningsklar skriving fremfor et datadump en ansettelsesansvarlig må grave seg gjennom.
Hvordan skiller du angitte fakta fra slutte egenskaper i en oppsummering?
Merk hver påstand som enten direkte observert (en fullført oppgave, et sitert svar) eller sluttet (en personlighetstrekk gjettet fra atferd). Å eksplisitt merke slutninger beskytter kandidater mot å bli nedgradert på egenskaper ingen faktisk testet.
Kan du overstyre en AI-generert score, og hvordan?
Ja. De fleste plattformer lar en gjennomgangsperson snu en regelnivå-vurdering eller justere en stjernvurdering, og den vektede totalen beregnes automatisk på nytt når endringen er gjort. Loggfør grunnen til overstyringen slik at beslutningen holder seg under senere gjennomgang.
Hva koster Talent Approved per kandidat?
Talent Approved tar $5 per kandidat som fullfører en vurdering, uten abonnementskrav, som oppgitt på prissiden. Du betaler bare for fullførte tester, ikke for å bygge eller sende selve vurderingen.
Bør en grenseverdi-score automatisk diskvalifisere en kandidat?
Nei. Score nær en grenseverdi bør utløse en nærmere titt på dokumentasjonslinjen fremfor automatisk avvisning, siden vurderingsresultater er relative og inneholder målefeil. Behandle tallet som et signal om å undersøke, ikke en endelig avgjørelse.