
Recruiter: Einseitige Leistungszusammenfassung-Vorlagen und KI-Prompts
Gesamteignung: Stark — der Kandidat hat jede zentrale technische Dimension mit verknüpften Belegen und ohne Integritätsverstöße erfüllt. Dieses einzeilige Urteil, gestützt durch eine einzige Begründung, die an rollenspezifische Belege geknüpft ist, steht in einer verwendbaren Leistungszusammenfassung stets an erster Stelle. Alles andere – von Stärken-Bullets bis hin zu Rubrik-Wertungen – unterstützt diese einleitende Einschätzung, anstatt sie zu vergraben.
TL;DR:
- Kandidaten, die alle zentralen technischen Prüfungen bestehen, demonstrieren in der Regel konsequente, vollständig getestete Arbeit ohne Integritätsverstöße, was das Urteil „stark geeignet" stützt.
- Belege für Stärken sollten spezifisch, mit Zeitstempel versehen oder direkt zitiert sein, während Lücken oder Bedenken anhand konkreter Momente oder Einreichungen identifiziert werden, die Schwächen offenbaren.
- Bewertungswerte sind relative Spannen; ein Wert nahe der Grenze erfordert eine manuelle Prüfung der Belege statt einer automatischen Ablehnung.
- Eine einseitige Zusammenfassung, bei der das Urteil an erster Stelle steht und Stärken sowie Bedenken auf jeweils drei bis fünf Bullets begrenzt sind, fördert eine schnellere und klarere Entscheidungsfindung.
- Eine menschliche Überprüfung ist bei Grenzwertbewertungen unerlässlich, mit ausdrücklicher Kennzeichnung sachlicher gegenüber abgeleiteter Merkmale und Dokumentation von Wertungsüberschreibungen für Prüfzwecke.
Inhaltsverzeichnis
- Wie sehen Beispiele für Leistungszusammenfassungen in der Praxis aus?
- Wie schreibt man eine Leistungszusammenfassung, die Auswahlgremien tatsächlich lesen?
- Wie sollten Rubrik-Wertungen und Wertungsspannen dargestellt werden?
- Wann sollte man eine KI-generierte Wertung überschreiben?
- Wie Talent Approved dies in den Überprüfungsprozess integriert
- Ein praktischer Hinweis aus der Praxis
- Den Vorlagen-Workflow ausprobieren, ohne ihn selbst aufzubauen
- Quellen
- FAQ
Wie sehen Beispiele für Leistungszusammenfassungen in der Praxis aus?
Eine Leistungszusammenfassung ist kein Transkript und kein Dashboard-Screenshot. Es handelt sich um ein komprimiertes, entscheidungsreifes Dokument, das das Urteil an erste Stelle setzt und es mit gerade genug Belegen untermauert, um die Entscheidung zu verteidigen. Berichte, die auf diese Weise aufgebaut sind, stellen die Eignungseinschätzung an den Anfang und begrenzen Stärken und Bedenken auf jeweils 3 bis 5 Bullets, mit jeweils einem unterstützenden Zitat oder einer Beweislinie pro Bullet.
So sieht das bei drei häufigen Ergebnissen aus, die Recruiter kommunizieren müssen: Einstellen, Möglicherweise geeignet und Zurückstellen.
Vorlage für Einstellung oder Endkandidaten
- Urteil: Eignung: Stark. Ein Satz, der die Entscheidung mit dem wichtigsten rollenspezifischen Beleg verknüpft (Beispiel: „Alle Backend-Architektur-Prüfungen mit sauberem, gestestetem Code beim ersten Versuch bestanden").
- Stärken (3 Bullets, jeweils eine Beweislinie): Spezifische Fähigkeit, Aufgabe oder Antwort, die dies belegt. Zeitstempel oder Auszugsreferenz, wo relevant.
- Bedenken (2 Bullets, jeweils eine Beweislinie): Genannte Lücke, mit dem genauen Moment oder der Einreichung, die diese offenbart hat.
- Dimensionsüberblick: Ein Satz pro Rubrikzeile (siehe nächsten Abschnitt für das Format).
- Integritätshinweis: Einwandfreie Sitzung oder Markierung mit Details.
- Nächste Schritte: Panelrunde planen oder zur Angebotsphase übergehen.
Vorlage „Möglicherweise geeignet"
- Urteil: Eignung: Möglicherweise, vorbehaltlich [spezifischer Lücke].
- 3 bis 4 Bullets zu dem, was gut funktioniert hat, jeweils mit einer Beweislinie.
- 2 Bullets, die die Lücke benennen und eine vorgeschlagene Folgemaßnahme enthalten, z. B. einen gezielten Nachtest oder ein 20-minütiges technisches Folgegespräch.
- Dimensionsüberblick mit der Grenzwertzeile explizit markiert.
Vorlage „Zurückstellen oder Nicht empfohlen"
- Urteil: Eignung: Für diese Stelle nicht empfohlen, klar und ohne Kommentierung formuliert.
- 3 Bullets zu dem, was der Kandidat gut gemacht hat, damit der Bericht fair bleibt.
- 2 bis 3 Bullets zu den spezifischen Lücken, die zur Entscheidung geführt haben, jeweils mit Beleg.
- Ein Satz dazu, ob der Kandidat für eine andere offene Stelle geeignet ist.
Jede Version hält sich an dieselben Einschränkungen: einzeiliges Urteil, 3 bis 5 Bullets pro Kategorie, ein Satz pro Dimension. Diese Disziplin sorgt dafür, dass ein Gremium aus fünf Prüfern dasselbe Dokument auf dieselbe Weise liest.
Wie schreibt man eine Leistungszusammenfassung, die Auswahlgremien tatsächlich lesen?
Die meisten Zusammenfassungen scheitern aus einem Grund: Sie wurden geschrieben, um Aufwand zu dokumentieren, nicht um eine Entscheidung voranzutreiben. Die Lösung beginnt, bevor der Kandidat die Beurteilung überhaupt abgeschlossen hat.
- Die Entscheidungsdimensionen zunächst mit dem einstellenden Manager festlegen. Einigen Sie sich auf 4 bis 6 Rubrikzeilen (technische Genauigkeit, Kommunikation, Problemlösung – was auch immer für die Stelle relevant ist), bevor die Ergebnisse eintreffen. Feste Dimensionen machen Kandidaten vergleichbar, und eine zwischendurch geänderte Rubrik zerstört diesen Vorteil.
- Belege pro Dimension während des Prozesses sammeln. Ein Zitat, ein Zeitstempel, ein Code-Ausschnitt, ein Einreichungsauszug. Vage Eindrücke halten einer Gremiumsherausforderung nicht stand.
- Die KI mit einem genauen Prompt-Muster anweisen. Legen Sie das Ausgabeformat fest, begrenzen Sie Bullets auf 5, verlangen Sie eine Beweislinie pro Aussage und weisen Sie die KI an, abgeleitete Merkmale (wie „vermutlich kooperativ") separat von festgestellten Fakten (wie „leitete ein Team von vier Personen") zu kennzeichnen.
- Längendisziplin einhalten. Eine Seite. Begrenzte Bullets. Ein Satz pro Dimensionsnotiz. Dies ist die einzige Gewohnheit, die ein Dokument, das ein einstellender Manager in neunzig Sekunden liest, von einem unterscheidet, das überflogen und ignoriert wird.
- Eine Integritätszusammenfassung mit einem Link zu Details hinzufügen. Eine einzige Zeile („Keine Markierungen, vollständige Sitzung aufgezeichnet") befriedigt die meisten Prüfer; verlinken Sie zum vollständigen Sitzungsprotokoll für diejenigen, die nachsehen möchten.
Profi-Tipp: Erstellen Sie Ihren KI-Prompt einmal, speichern Sie ihn als Vorlage und verwenden Sie ihn für jede Stelle wieder. Konsistenz über alle Zusammenfassungen hinweg ist wichtiger als die Perfektionierung einer einzelnen.
Wie sollten Rubrik-Wertungen und Wertungsspannen dargestellt werden?
Jede Dimensionszeile benötigt vier Dinge: die Bezeichnung, die Bewertung, eine einzeilige Beweisangabe und eine Markierung, ob die Bewertung festgestellt oder abgeleitet ist. Lässt man die Markierung weg, lädt man ein Gremium dazu ein, eine Vermutung als Tatsache zu behandeln.
Eine allgemeine 4-Punkte-Rubrikzeile könnte wie folgt aussehen:
| Dimension | Bewertung | Beleg | Grundlage |
|---|---|---|---|
| Technische Genauigkeit | Stark | Alle 4 Testfälle beim ersten Einreichen bestanden | Festgestellt |
| Kommunikation | Durchschnittlich | Klare Erklärung der Logik, etwas Zögern unter Zeitdruck | Festgestellt |
| Problemlösung | Stark | Wählte ohne Aufforderung den effizienteren von zwei gültigen Ansätzen | Festgestellt |
| Kulturelle Fit-Signale | Durchschnittlich | Antworten deuten auf kooperativen Stil hin, nicht direkt getestet | Abgeleitet |
Wertungen sind Spannen, keine eigenständigen Urteile. Beurteilungsergebnisse sind relativ und weisen Messfehler auf, was bedeutet, dass sie anhand rollenspezifischer Normen gelesen werden sollten, anstatt als harte Grenzwerte behandelt zu werden. Ein Kandidat, der knapp unter einem Schwellenwert liegt, verdient einen zweiten Blick statt einer automatischen Ablehnung, insbesondere bei einer Dimension, hinter der nur wenige Belege stehen.
- Das gewichtete Gesamtergebnis einmal, in der Nähe des Urteils, präsentieren – nicht über die Seite verstreut.
- Die Rechenweise pro Dimension nur dann zeigen, wenn ein Prüfer darum bittet; die Zusammenfassung selbst sollte auf einer Seite bleiben.
- Jede Dimension, bei der die Wertung innerhalb weniger Punkte des Grenzwerts liegt, als „nahe am Schwellenwert" markieren, damit Prüfer wissen, dass sie die Beweislinie lesen sollten, anstatt allein der Zahl zu vertrauen.
Wann sollte man eine KI-generierte Wertung überschreiben?
KI-gestützte Auto-Scoring-Tools zeigen in der Regel aufklappbare Stern-Aufschlüsselungen und schriftliche Begründungen, die ein Prüfer öffnen kann, bevor er eine Bezeichnung akzeptiert. Behandeln Sie diese Begründung als das Erste, was zu prüfen ist – nicht die Wertung selbst.
- Zuerst den Beleg-Link prüfen. Öffnen Sie das verknüpfte Transkript, den Code-Ausschnitt oder den Videoclip hinter der Wertung. Wenn die Begründung nicht mit dem übereinstimmt, was Sie sehen, ist das Ihr Auslöser für eine Überschreibung.
- Integritätsmarkierungen prüfen. Jede Markierung verändert, wie viel Gewicht die Wertung verdient, unabhängig von der zugehörigen Zahl.
- Auf Regelebene überschreiben. Die meisten Plattformen ermöglichen es, eine bestimmte Regel zu ändern oder eine Stern-Bewertung anzupassen, und das gewichtete Gesamtergebnis wird automatisch neu berechnet.
- Grenzfälle eskalieren. Wenn ein Kandidat bei einer rollenentscheidenden Dimension ungefähr einen Punkt von Ihrem Grenzwert entfernt liegt, leiten Sie den Fall an ein Gremium weiter oder fordern Sie einen kurzen menschlichen Nachtest an, anstatt einer einzigen automatisierten Wertung zu vertrauen.
- Die Änderung protokollieren. Erfassen Sie, wer die Wertung überschrieben hat, warum und welches neue gewichtete Gesamtergebnis daraus resultiert. Diese Prüfspur schützt die Entscheidung später.
Statistik-Hinweis: Eine Wertung nahe dem Schwellenwert ist ein Anlass zur Überprüfung, keine Ablehnung. Behandeln Sie jede Dimensionswertung innerhalb einer engen Spanne Ihres Grenzwerts als Signal, die Beweislinie selbst zu prüfen, da Beurteilungsergebnisse konstruktionsbedingt Messfehler aufweisen.
Wie Talent Approved dies in den Überprüfungsprozess integriert
Jede Vorlage und jede Checkliste oben ist direkt auf Funktionen abgestimmt, die in die Plattform von Talent Approved integriert sind. Magic Create generiert die rollenspezifische Rubrik in wenigen Minuten aus einer Stellenbeschreibung, sodass die Dimensionen festgelegt sind, bevor der erste Kandidat den Test abschließt. Die KI-generierte Zusammenfassung, die dabei herauskommt, folgt derselben Disziplin: Urteil oben, belegsverknüpfte Bewertungen und ein einseitiges Layout statt eines rohen Datendumps.
- Strukturierte Rubriken ersetzen ad-hoc-Bewertungen durch konsistente, vergleichbare Dimensionen für jeden Kandidaten. Sehen Sie die Checkliste für Kandidatenbewertungskriterien der Plattform für die Definition dieser Dimensionen.
- Anti-Cheat-Überwachung, einschließlich Bildschirm- und Webcam-Prüfungen, fließt direkt in den Integritätshinweis der Zusammenfassung ein.
- Sitzungswiederholungen und Beleg-Links ermöglichen es einem Prüfer, eine Bewertung in Sekunden zu verifizieren – derselbe Überschreibungs-Workflow wie oben beschrieben.
- Kandidatenrankings übertragen die gewichteten Gesamtergebnisse, sodass ein Gremium Endkandidaten vergleichen kann, ohne eine Scorecard manuell neu zu erstellen. Lesen Sie, wie schnelle Kandidatenbewertung für Recruiter funktioniert, für einen genaueren Blick auf die Mechanismen.
Ein praktischer Hinweis aus der Praxis
Drei Fehler bringen die meisten Leistungszusammenfassungen zum Scheitern: das Ändern von Rubrik-Dimensionen zwischen Kandidaten, das Schreiben von Berichten, die lang genug sind, um das Urteil zu vergraben, und das Behandeln einer KI-Wertung als endgültig anstatt als Ausgangspunkt für die Überprüfung.
Drei Korrekturen wirken schnell. Begrenzen Sie jede Zusammenfassung auf eine Seite. Stellen Sie das Urteil immer in die erste Zeile. Und verlangen Sie eine menschliche Überprüfung bei jeder Wertung nahe Ihrem Grenzwert, bevor sie das Ergebnis eines Menschen bestimmt. Probieren Sie diese Vorlagen bei Ihrer nächsten Vorauswahl aus, bevor Ihre nächste vollständige Einstellungsrunde beginnt. Sie werden den Unterschied bemerken, wie schnell Ihr Gremium tatsächlich zu einer Einigkeit kommt.
— Jimmie
Den Vorlagen-Workflow ausprobieren, ohne ihn selbst aufzubauen
Die Plattform verwandelt alles in diesem Leitfaden in etwas, das Sie nicht manuell aufbauen müssen. Sie kann eine Rubrik aus einer Stellenbeschreibung erstellen, Integritätshinweise automatisch erfassen und eine urteilszuerst- und belegsverknüpfte KI-generierte Zusammenfassung wie beschrieben produzieren.
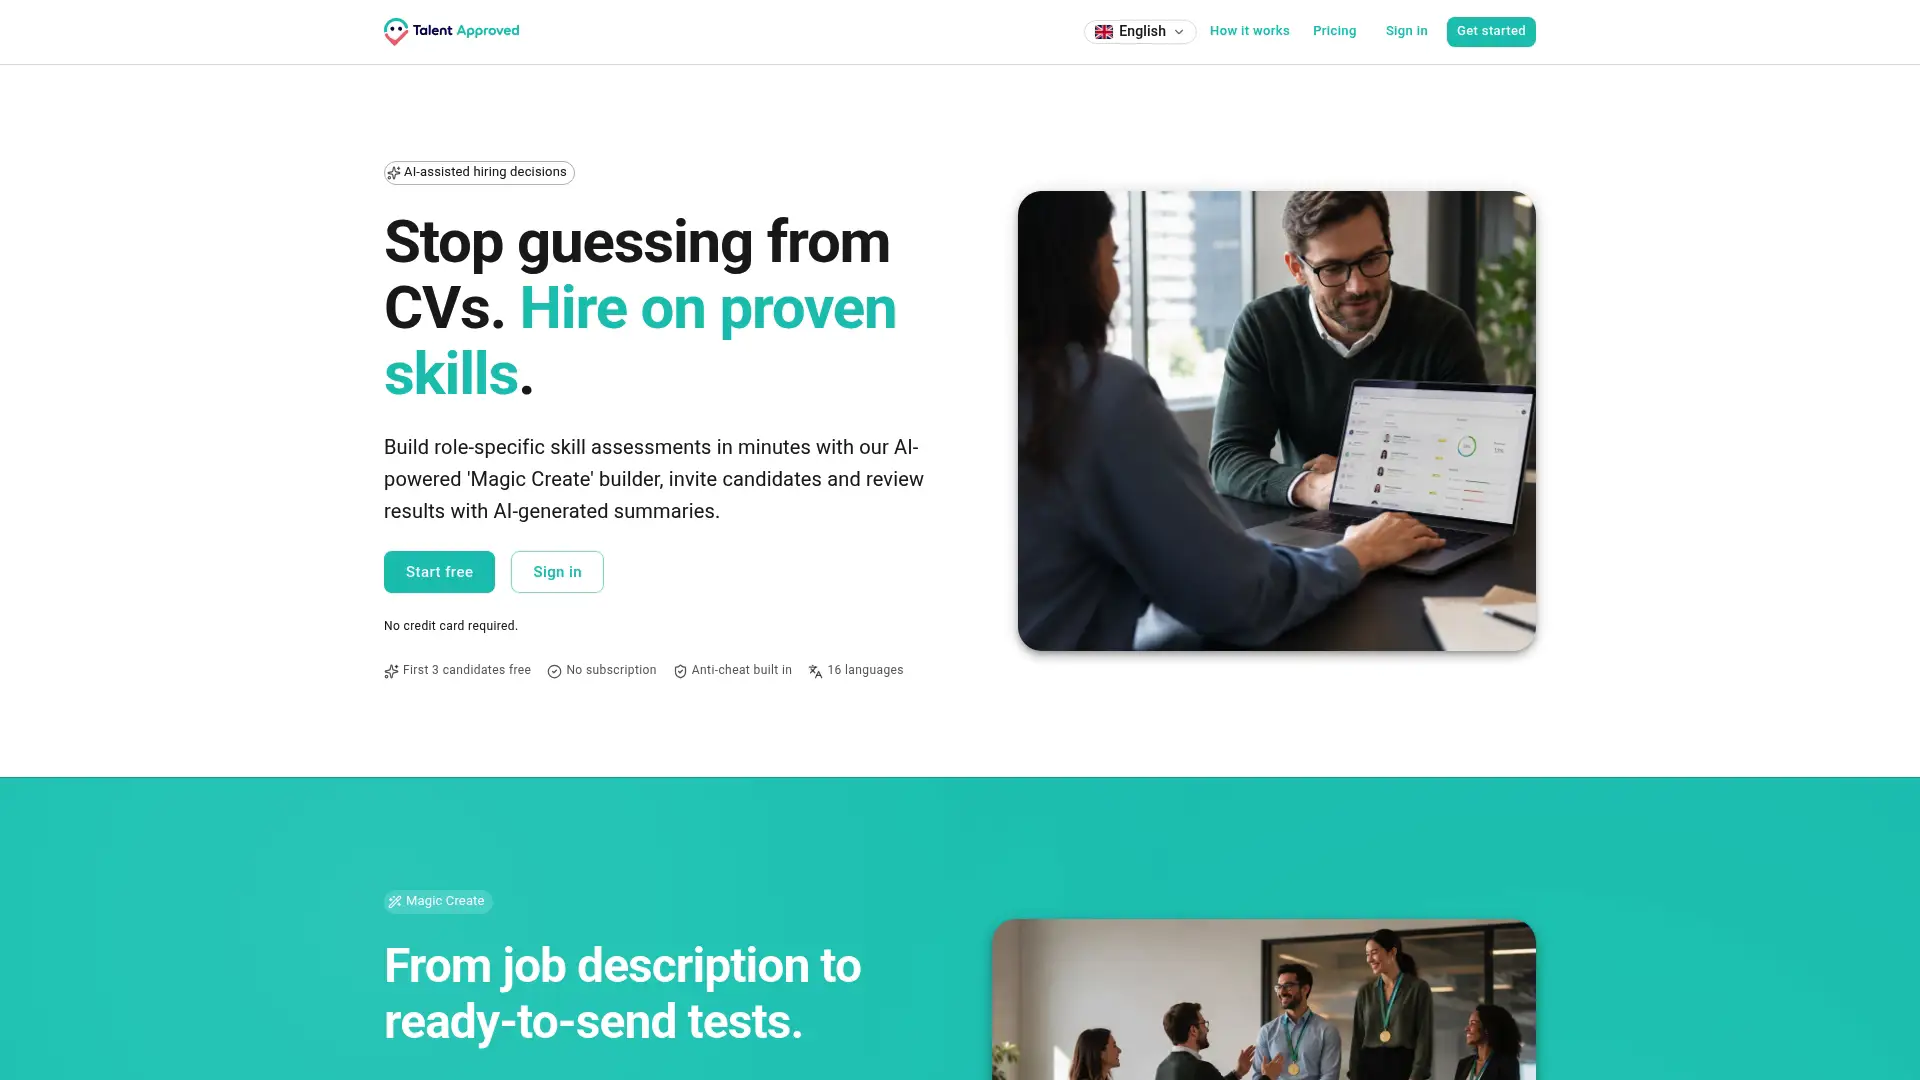
Es ist kein Abonnement erforderlich, um zu beginnen. Talent Approved funktioniert nach einem Pay-as-you-go-Modell: 5 $ pro Kandidat, der eine Beurteilung abschließt, wie auf der Preisseite beschrieben. Führen Sie eine Stelle damit durch, vergleichen Sie die erhaltene Zusammenfassung mit den Vorlagen oben und entscheiden Sie dann, ob sie zu Ihrem Einstellungsworkflow passt.
Quellen
- Sharing Interview Results With Hiring Stakeholders: PDF Reports Done Right | ClarityHire
- Skill
- How Do You Review AI Auto-Scoring Results in Canditech? | Canditech Help Center
- A Step-by-Step Guide to Interpreting Skill Assessment Results | Riot IQ
FAQ
Was ist die ideale Länge für eine Kandidaten-Leistungszusammenfassung?
Eine Seite, mit Stärken und Bedenken auf jeweils 3 bis 5 Bullets begrenzt und einem Satz pro Rubrik-Dimension. Diese Länge erzwingt belegsgestütztes, entscheidungsreifes Schreiben anstelle eines Datendumps, durch den sich ein einstellender Manager durcharbeiten muss.
Wie trennt man festgestellte Fakten von abgeleiteten Merkmalen in einer Zusammenfassung?
Kennzeichnen Sie jede Aussage entweder als direkt beobachtet (eine abgeschlossene Aufgabe, eine zitierte Antwort) oder als abgeleitet (ein aus dem Verhalten geschlossenes Persönlichkeitsmerkmal). Das explizite Markieren von Ableitungen schützt Kandidaten davor, aufgrund von Merkmalen abgewertet zu werden, die niemand tatsächlich getestet hat.
Kann man eine KI-generierte Wertung überschreiben, und wie?
Ja. Die meisten Plattformen ermöglichen es einem Prüfer, eine regelbasierte Bewertung zu ändern oder eine Stern-Wertung anzupassen, und das gewichtete Gesamtergebnis wird automatisch neu berechnet, sobald die Änderung vorgenommen wurde. Protokollieren Sie den Grund für die Überschreibung, damit die Entscheidung einer späteren Überprüfung standhält.
Was kostet Talent Approved pro Kandidat?
Talent Approved berechnet 5 $ pro Kandidat, der eine Beurteilung abschließt, ohne erforderliches Abonnement, wie auf der Preisseite angegeben. Sie zahlen nur für abgeschlossene Tests, nicht für das Erstellen oder Versenden der Beurteilung selbst.
Sollte eine Grenzwert-Wertung einen Kandidaten automatisch disqualifizieren?
Nein. Wertungen nahe einem Grenzwert sollten eine genauere Prüfung der Beweislinie auslösen und keine automatische Ablehnung, da Beurteilungsergebnisse relativ sind und Messfehler aufweisen. Behandeln Sie die Zahl als Signal zur Untersuchung, nicht als endgültiges Urteil.