
6 Valideringskontroller HR Må Kreve fra Automatisert Vurderingsfeedback
Automatisert vurderingsfeedback er KI-genererte scorer, sammendrag og anmerkninger fra sensorer, produsert av en plattform for ferdighetsvurdering, for å støtte ansettelsesavgjørelser. Det gjør screening raskere og holder karaktergivingen konsistent på tvers av store kandidatpooler, men det fortjener bare din tillit når resultatet bygger på validerte kriterier, gjennomgås av et menneske, og leveres med en tydelig forklaring til både rekrutterere og kandidater.
Kort oppsummert:
- Automatisert vurderingsfeedback må valideres for å sikre at scorene måler relevante ferdigheter og korrelerer med faktisk jobbprestasjon.
- Klare forklaringer tilpasset både ledere og kandidater er avgjørende – med detaljer om hva som ble vurdert, hvor sikker modellen er, og hvor dens begrensninger ligger.
- Menneskelig gjennomgang forblir kritisk, særlig nær grenseverdier, med formelle prosedyrer og terskler på plass før utrulling.
- Leverandører bør fremlegge nylige resultater fra skjevhetstesting, revisjonslogger og detaljerte valideringsrapporter for å verifisere verktøyets rettferdighet og nøyaktighet.
- Pilottesting med grundig dokumentasjon og løpende overvåking bidrar til å sikre at vurderingssystemet pålitelig støtter ansettelser uten skjevheter eller juridiske risikoer.
Innholdsfortegnelse
- Hvorfor automatisert vurderingsfeedback er viktig for ansettingsteam
- Hva pålitelig automatisert vurderingsfeedback må inneholde
- Slik evaluerer du en plattforms automatiserte feedback før du kjøper
- Rulle ut automatisert vurderingsfeedback uten å miste kontrollen
- Maler for kandidat- og sensorsammendrag
- Behandle automatisert feedback som støtte, ikke som det siste ordet
- Hvordan Talent Approved passer inn i en ansvarlig utrulling
- Kilder
- FAQ
Hvorfor automatisert vurderingsfeedback er viktig for ansettingsteam
Å screene 200 søkere manuelt for én stilling tar dager. Et automatisert karaktersystem innebygd i en plattform for ferdighetsvurdering kan score og oppsummere den samme poolen på timer – og det er grunnen til at de fleste høyvolumsansettingsteam allerede har tatt i bruk en eller annen form for det, for å dra nytte av den forbedringen av rekrutteringskvaliteten som KI-vurdering gir. Fordelen strekker seg lenger enn bare fart.
Kandidater som venter i ukevis på svar har en tendens til å miste interessen eller akseptere et annet tilbud. Verktøy for øyeblikkelig feedback korter ned dette gapet og gir søkerne en følelse av at prosessen respekterer tiden deres – noe SIOPs forskning på søkerreaksjoner knytter direkte til hvor rettferdig kandidater vurderer hele ansettelsesprosessen.
Risikoen ligger på den andre siden av samme mynt:
- En score uten forklaring bak seg forteller en ansettelsesleder ingenting om hvorvidt den gjenspeiler en reell, jobbrelevant ferdighet.
- En uvalidert test kan belønne egenskaper som ikke har noe med jobbprestasjon å gjøre.
- En modell trent uten skjevhetskontroller kan stille en beskyttet gruppe i ulempe uten at noen merker det, og arbeidsgiveren forblir juridisk ansvarlig selv når et tredjeparts leverandør har bygget verktøyet.
Fart uten validering er bare rask gjetting.
Hva pålitelig automatisert vurderingsfeedback må inneholde
Før du stoler på en eneste score fra en hvilken som helst programvare for vurderingsfeedback, bør du sjekke den mot seks kriterier hentet fra faglig og regulatorisk veiledning.
- Valideringsbevis. Plattformen bør vise at scorene måler jobbrelevante kunnskaper, ferdigheter, evner og andre egenskaper (KSAOer) og korrelerer med faktisk jobbprestasjon. Et polert KI-generert sammendrag er ikke i seg selv bevis på validitet.
- Tilpasset forklarbarhet. Ansettelsesledere trenger handlingsorienterte detaljer: hva som ble målt, hvor sikker modellen er, og hvor dens begrensninger ligger. Kandidater trenger noe enklere: hva som ble vurdert og hvordan man kan reise en innvending – et skille som NISTts rammeverk trekker opp eksplisitt.
- Menneskelig gjennomgang med definerte terskler. En kvalifisert person godkjenner før et avslag sendes ut, særlig nær grenseverdier.
- Personvern og innsyn. Kandidater bør vite hvilke data som samles inn, hvor lenge de oppbevares, og hvem som kan få tilgang til dem.
- Skjevhetstesting og løpende overvåking. Scorene kontrolleres for uforholdsmessig negativ effekt ved lansering og kontrolleres på nytt etter en plan – ikke bare én gang.
- Revisjonsspor og versjonssporing. Enhver score skal kunne spores tilbake til modellversjonen og kildesvarene som produserte den.
Proffips: Be enhver leverandør om de nyeste resultatene fra deres test for uforholdsmessig negativ effekt før du signerer – ikke etter din første ansettelsesrunde. Hvis de ikke kan fremlegge ett slikt dokument, har du svaret ditt.
Slik evaluerer du en plattforms automatiserte feedback før du kjøper
En strukturert pilottest slår en salgsdemo hver gang. Før du forplikter budsjettet, be om følgende fra enhver leverandør av programvare for vurderingsfeedback:
- Et kartleggingsdokument for jobbanalyse som viser hvilke spørsmål som er knyttet til hvilke KSAOer.
- Validerings- og skjevhetstestrapporter – ikke markedsføringspåstander om nøyaktighet.
- Eksempler på sammendrag rettet mot kandidater og sensorer som du faktisk kan lese.
- Dokumentasjon av perioder for dataoppbevaring og hvem hos leverandøren som kan få tilgang til kandidatsvar.
Under selve piloten bør du revidere et tilfeldig utvalg av scorede kandidater manuelt og sammenligne din vurdering med maskinens. Følg med på tid til feedback, siden det tallet forteller deg om verktøyet faktisk sparer teamet ditt for timer eller bare flytter flaskehalsen. Les forklaringene rettet mot kandidater som om du var søkeren selv. Hvis de fremstår som en svart boks, vil kandidatene merke det også.
På kontraktssiden bør du bekrefte at leverandøren kan fremlegge revisjonslogger, klargjøre hvem som eier dataene etter at forholdet avsluttes, og fastsette eskaleringsrutiner når en kandidat bestrider et resultat. Leverandørens involvering overfører aldri det juridiske ansvaret for utfallet til leverandøren. Det ansvaret forblir hos deg.
Proffips: Sett en terskel for menneskelig godkjenning før piloten starter – for eksempel automatisk manuell gjennomgang for alle som scorer innenfor fem poeng av grenseverdien din. Å bestemme dette etter at resultatene foreligger, inviterer skjevhet inn i beslutningen.
Rulle ut automatisert vurderingsfeedback uten å miste kontrollen
En ansvarlig utrulling følger en sekvens, ikke én enkelt lanseringsdato.
- Kartlegg stillingen. Dokumenter de KSAOene jobben faktisk krever, og velg én eller to pilotroller med nok ansettelsesvolum til å generere meningsfulle data.
- Sett suksessmålinger på forhånd. Bestem hva «fungerer» betyr: tid til feedback, grad av enighet blant sensorer, kandidattilfredshet – eller alle tre.
- Kjør piloten og test for uforholdsmessig negativ effekt. Sammenlign beståttandeler på tvers av demografiske grupper før du skalerer til flere roller. Det er her strukturert testing for uforholdsmessig negativ effekt virkelig beviser sin verdi.
- Bygg inn innsyn og korreksjonsmuligheter. Kandidater trenger en måte å be om tilrettelegging eller bestride et resultat på før det blir endelig.
- Tren sensorer og sett opp en revalideringskalender. Sensorer trenger tydelige eskaleringsregler, og hele systemet trenger en planlagt gjennomgang – ikke noe som overlates til tilfeldighetene.
Å hoppe over trinn for å lansere raskere er nøyaktig slik team ender opp med å feilsøke klager om skjevhet i stedet for å ansette.
Maler for kandidat- og sensorsammendrag
Formatet på sammendraget betyr nesten like mye som selve scoren. Et sammendrag rettet mot kandidaten bør navngi områdene som ble vurdert, gi konkrete bevis («scoret i øverste kvartil på spørsmål om datatolkning»), og forklare hvordan man ber om en gjennomgang. Et sammendrag rettet mot sensoren trenger motsatt vektlegging: råscorer koblet tilbake til spesifikke KSAOer, pluss et forslag til neste handling – ikke bare ett enkelt sammensatt tall.
Noen regler holder begge dokumenter ærlige:
- Ta vare på råsvarene og scoringslogikken bak hvert sammendrag, slik at et menneske kan rekonstruere resonnementet senere.
- Knytt hvert utsagn i sammendraget til det spesifikke spørsmålet eller oppgaven som produserte det.
- Presenter aldri én score som det endelige svaret. Par den med kontekst som en ansettelsesleder kan veie mot annen dokumentasjon – en tilnærming som hvordan rollespecifikke tester bygges dekker mer inngående.
Talent Approveds Magic Create-funksjon bygger rollespesifikke vurderinger direkte fra en stillingsbeskrivelse, og genererer deretter disse parede sammendragene automatisk – slik at sensorer får en startmal i stedet for en blank side.
Behandle automatisert feedback som støtte, ikke som det siste ordet
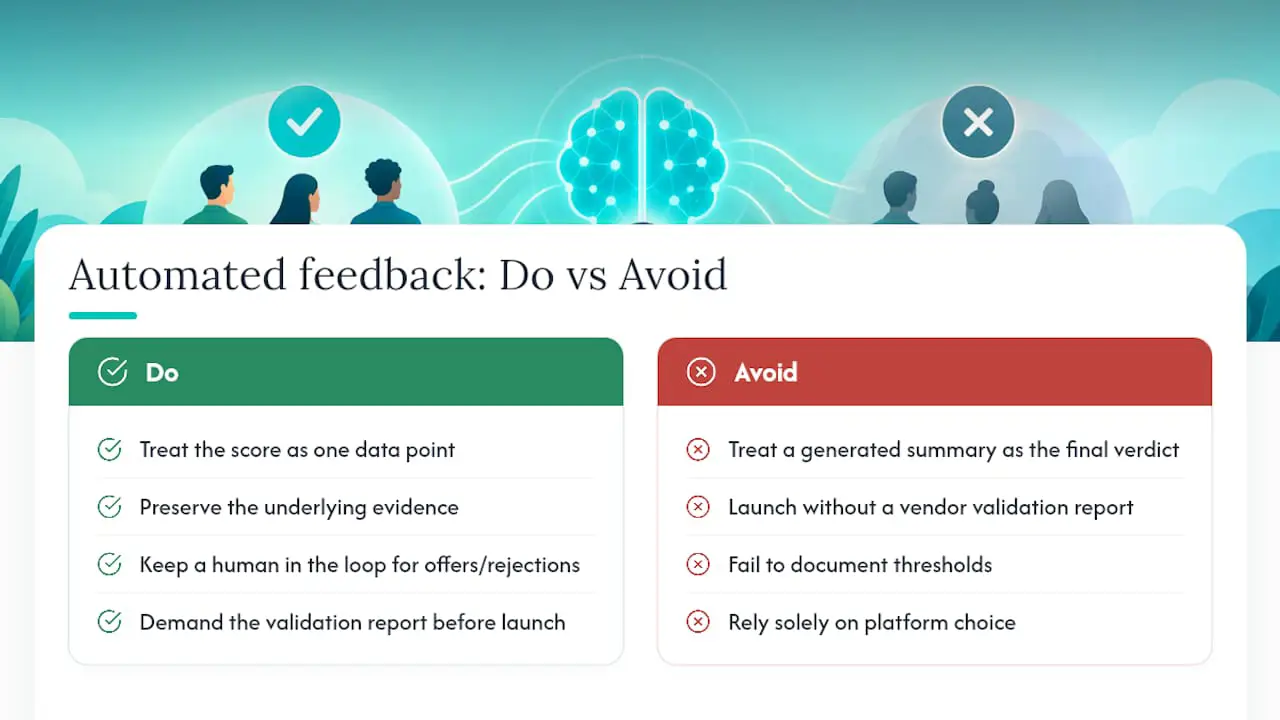
Den største feilen jeg ser ansettingsteam gjøre, er ikke å velge feil plattform. Det er å glemme at et generert sammendrag er et innspill, ikke en dom. Behandle scoren som ett datapunkt, bevar det underliggende beviset slik at du kan forsvare beslutningen senere, og hold et menneske i loopen for alt som berører et tilbud eller et avslag.
Pilotprosjekter pleier å overraske folk på samme måte: scoredistribusjonen ser fin ut helt til noen ber om valideringsrapporten – og leverandøren ikke har den klar. Krev den før lansering, ikke etter en klage. Dokumenter hvorfor du valgte de tersklene du gjorde. Det papirarbeidet er det som beskytter ansettelsesavgjørelsene dine måneder senere, når noen uunngåelig spør hvorfor.
— Jimmie
Hvordan Talent Approved passer inn i en ansvarlig utrulling
Talent Approved er bygget for HR-team som ønsker scoringshastighet uten å gi opp den oversynet denne guiden går gjennom. Magic Create gjør en stillingsbeskrivelse om til en rollespesifikk test på minutter, anti-juks-overvåking og sesjonsavspillinger holder bevisene intakte for senere gjennomgang, og KI-genererte sammendrag parer scorer med den konteksten en sensor faktisk trenger.
I stedet for et abonnement tar Talent Approved 5 dollar per fullført kandidatvurdering, slik at en liten pilot på én eller to roller koster nesten ingenting å teste mot din egen valideringssjekkliste. Før du ruller det ut videre, be om eksempelsammendrag og data fra skjevhetstesting på samme måte som denne guiden anbefaler å spørre enhver leverandør. Besøk deretter prissiden for å starte en pilot på din neste åpne stilling.
Kilder
- Vurderinger og anbefalinger for validering og bruk av KI-baserte vurderinger i medarbeiderseleksjon (SIOP)
- Rammeverk for KI-risikostyring (NIST)
- Hva er EEOCs rolle i KI? (EEOC)
FAQ
Hva er automatisert vurderingsfeedback i ansettelsesprosessen?
Det er de KI-genererte scorene, sammendragene og sensornotatene en plattform for ferdighetsvurdering produserer etter at en kandidat har fullført en test. Det støtter rekruttererens beslutninger, men fungerer best i kombinasjon med menneskelig gjennomgang og dokumentert valideringsbevis.
Er automatisert vurderingsfeedback juridisk risikabelt?
Det kan det være, hvis scorene ikke er validert eller skjevhetstestet. EEOCs veiledning bekrefter at arbeidsgivere forblir ansvarlige for uforholdsmessig negativ effekt selv når en leverandør har bygget verktøyet.
Hva koster Talent Approved?
Talent Approved bruker en betal-etter-bruk-modell priset til 5 dollar per fullført kandidatvurdering, uten behov for abonnement.
Hvordan vet jeg om en leverandørs feedback er til å stole på?
Be om valideringsbevis som knytter scorer til jobbrelevante ferdigheter, en fersk skjevhetstestrapport og eksempler på revisjonslogger. Hvis en leverandør ikke kan fremlegge disse, sier SIOPs valideringsrammeverk at du ikke bør stole på scorene ennå.
Bør kandidater kunne anke en automatisert score?
Ja. Å gi kandidater en måte å bestride resultater på og motta rettidig, informativ feedback forbedrer opplevelsen av rettferdighet og er en kjerneanbefaling i SIOPs forskning på søkerreaksjoner.