
Undvik juridisk risk: HR:s checklista för validering av flerspråkiga bedömningar
Flerspråkiga bedömningar är rollspecifika kompetenstester, inte språkprov, översatta och lokaliserade till de språk dina kandidater faktiskt arbetar på. Lokalisering är en mätuppgift, inte en översättningsuppgift: en version som läses flytande på portugisiska men ger andra poäng än det engelska originalet har misslyckats med sin uppgift. Innan du skickar ett lokaliserat test till en enda verklig kandidat bör du pilottesta det, utföra ekvivalenskontroller och dokumentera vad du hittar.
Sammanfattning:
- Validering bör börja med en grundlig jobbanalys och tydliga kompetensdefinitioner för att säkerställa att bedömningen mäter relevanta färdigheter för rollen.
- Pilottestning på flera språk med tvåspråkiga respondenter hjälper till att identifiera ekvivalensproblem tidigt och förhindrar felaktiga anställningsbeslut.
- Valideringsmetoder som DIF-analys, ANCOVA och spårning av uppgiftssvärighetsgrad är nödvändiga för att bekräfta att olika språkversioner fungerar på liknande sätt.
- Arbetsgivare måste dokumentera valideringsinsatser, pilotresultat och poängbeslut för att kunna försvara sig mot rättsliga utmaningar relaterade till negativ inverkan eller icke-ekvivalens.
- Fullständigt validerade bedömningar kräver disciplinerade arbetsflöden, inklusive förenkling, oberoende översättningar, granskning av tvåspråkiga experter och omvalidering vid fastställda intervall.
Innehållsförteckning
- Vad "flerspråkiga bedömningar" faktiskt innebär för rekrytering
- Hur validerar du en lokaliserad bedömning?
- Hur ser en lokaliseringschecklista ut i praktiken?
- Vilka är de juridiska riskerna med flerspråkiga rekryteringstester?
- Vad HR-team konsekvent gör fel när det gäller lokalisering
- Hur Talent Approved förenklar utrullning av flerspråkiga bedömningar
- Källor
- Vanliga frågor
Vad "flerspråkiga bedömningar" faktiskt innebär för rekrytering
En flerspråkig bedömning mäter om en kandidat kan utföra jobbet, på vilket språk de än tänker på. Det är inte ett test av hur väl någon talar eller skriver engelska, spanska eller mandarin. Den distinktionen verkar självklar tills du ser hur många arbetsgivare som blandar ihop det. Ett kodningstest med tät engelska instruktioner kontrollerar inte bara kodningsfärdighet; det kontrollerar också läshastighet på ett andraspråk, och det andra, oavsiktliga måttet är precis det som ställer till problem för arbetsgivare.
EEOC är tydlig med att ett översatt eller lokaliserat kompetenstest fortfarande är ett urvalsförfarande. Arbetsgivare är fortsatt ansvariga för att bevisa att det är jobbanknutet och validerat, i varje språk det erbjuds på. Fördelen med att göra detta korrekt är verklig: du öppnar din rekryteringspipeline för kvalificerade kandidater som annars skulle sållas bort på grund av språkfriktion som inte har något med rollen att göra. Risken med att göra det oaktsamt är lika verklig.
- Konstruktdrift: den lokaliserade versionen mäter tyst något annat än den avsedda kompetensen.
- Icke-ekvivalens: kandidater som är lika kapabla får olika poäng beroende på vilken språkversion de använde.
- Negativ inverkan: en språkgrupp godkänns med märkbart lägre frekvens, vilket kan utlösa juridisk exponering under UGESP.
Empirisk forskning stödjer detta direkt: studier som utvärderat översatta arbetsplatsundersökningar över språk och kulturer har funnit mätbara strukturella skillnader mellan versioner som såg identiska ut på pappret.
Hur validerar du en lokaliserad bedömning?
Validering börjar innan översättning, inte efter. Genomför en jobbanalys först: definiera exakt vilka kompetenser rollen kräver och skriv operationella definitioner för var och en. Det steget ger dig innehållsvaliditet, den grund som UGESP ber arbetsgivare att demonstrera under 29 CFR Part 1607.
Vilken valideringsstrategi du lutar dig mot beror på hur testet används. Ett godkänt/underkänt screeningtest för en ingångsnivå-roll kan ofta förlita sig enbart på innehållsvaliditet, tätt kopplad till arbetsuppgifter. Ett test som används för att rangordna finalister för en högrisk-roll förtjänar kriteriebaserade eller konstruktbaserade valideringsbevis, eftersom insatserna för att få ordningen fel är högre.
Själva översättningen behöver skyddsräcken. ITC:s riktlinjer för översättning och anpassning av tester rekommenderar en specifik sekvens:
- Förenkla källuppgiften först. Ta bort idiom, kulturbundna referenser och onödig läsbelastning innan någon översätter ett enda ord.
- Beställ oberoende framåtöversättningar och stäm sedan av skillnaderna med en andra översättare eller ett team.
- Låt tvåspråkiga ämnesexperter granska uppgiften för realism och jobbdybarhet, inte bara grammatisk korrekthet.
- Bakåtöversätt där insatserna motiverar den extra tiden, och jämför sedan mot originalet för betydelsedrift.
- Pilottesta den färdiga versionen med tvåspråkiga respondenter innan den någonsin når en verklig kandidatpool.
Piloten är där ekvivalens testas, inte antas. Logga genomförandetid, uppgiftsnivå-svårighetsgrad och godkännandefrekvens per språk. Kollegialt granskad metodik för utvärdering av språkversioner av certifieringsprov använder verktyg som analys av differentiell uppgiftsfunktion (DIF), multidimensionell skalning och ANCOVA för att flagga uppgifter som beter sig annorlunda i olika versioner, även när formuleringen ser ut som en ren översättning.
Proffstips: Genomför din pilot med åtminstone en liten grupp tvåspråkiga medarbetare som kan flagga när en "korrekt" översättning ändå känns onaturlig eller tvetydig i sitt sammanhang. Infödd språkfärdighet fångar problem som bakåtöversättning ensamt missar.
Pilottestning med tvåspråkiga respondenter och grundläggande statistiska kontroller fångar de flesta ekvivalensfel tidigt, enligt forskning om certifieringsprovs ekvivalens, långt innan en felaktig uppgift påverkar ett verkligt anställningsbeslut. Håll ett skriftligt register över varje översättningsbeslut, varje pilotresultat och varje poängjustering. Om negativ inverkan någonsin ifrågasätts är det det spåret som låter dig försvara testet snarare än att dra tillbaka det.
Hur ser en lokaliseringschecklista ut i praktiken?
De flesta HR-team behöver inte en psykometriexamen för att genomföra detta väl. De behöver en upprepningsbar sekvens och disciplinen att följa den varje gång, även den femte gången när deadline är tight och det känns frestande att hoppa över ett steg.
- Definiera kompetensen och bygg poängrubrik innan du skriver en enda fråga.
- Bestäm det avsedda syftet i förväg: att screena kandidater in, eller att rangordna finalister mot varandra.
- Förenkla källuppgifter så att de översätts rent, ta bort idiom och tät jargong.
- Beställ oberoende framåtöversättningar och stäm sedan av dem med ett tvåspråkigt granskningsteam.
- Lägg till bakåtöversättning för högrisk-roller där ett poängfel får verkliga konsekvenser.
- Pilottesta med tvåspråkiga respondenter och logga genomförandetid, uppgiftssvärighetsgrad och godkännandefrekvens.
- Vänta med hårda gränsvärden tills pilotdata visar att språkversionerna beter sig konsekvent.
- Dokumentera varje steg och sätt ett omvalideringsdatum, inte en "någon gång"-platshållare.
| Arbetsflödessteg | Vad du kontrollerar | Varningssignal att hålla utkik efter |
|---|---|---|
| Jobbanalys | Kompetensen matchar faktiska arbetsuppgifter | Testet mäter färdigheter rollen inte behöver |
| Översättning | Betydelsen bevaras, inte bara formuleringen | Idiom eller kulturspecifika referenser kvarstår |
| Tvåspråkig SME-granskning | Uppgiften känns naturlig och jobbrelevant | Granskaren flaggar klumpig eller tvetydig formulering |
| Pilottestning | Genomförandetid, svårighetsgrad, godkännandefrekvens per språk | En språkgrupp tar märkbart längre tid eller får lägre poäng |
| Gränsvärdesbeslut | Poängsättningen är konsekvent över versioner | Samma förmågenivå, olika utfall per språk |
En leverantör som inte kan gå igenom vart och ett av dessa steg med dig, eller inte kan ta fram pilotdata på begäran, erbjuder inte en validerad bedömning. De erbjuder en översatt – och det är inte samma produkt. Talent Approveds egen checklista för bedömningslokalisering går igenom den här sekvensen mer ingående om du bygger processen internt.
Vilka är de juridiska riskerna med flerspråkiga rekryteringstester?
Att använda en leverantör överför inte ditt juridiska ansvar. Enligt EEOC:s vägledning är arbetsgivaren som administrerar testet fortsatt ansvarig för att visa att det är jobbanknutet och validerat, oavsett vem som byggde det eller vilket språk det levereras på. OFCCP:s vägledning förstärker samma poäng för federala leverantörer som använder kognitiva tester, jobbsimuleringar och andra poängsatta urvalsverktyg.
Håll ett försvarbart register för varje lokaliserat test du driftsätter:
- Den ursprungliga jobbanalysen och kompetensdefinitionerna.
- Valideringsbevis för varje språkversion, inte bara källspråket.
- Administreringsregler, inklusive tidsgränser och provövervakningsvillkor.
- Pilotdata: genomförandetid, uppgiftssvärighetsgrad, godkännandefrekvens per språkgrupp.
- Leverantörens valideringsrapporter, om testet köptes snarare än byggdes internt.
- Motiveringen bakom ditt gränsvärde och eventuella justeringar gjorda efter pilotgranskning.
Rangordning av kandidater medför större juridisk exponering än en enkel godkänd/underkänd-screening, eftersom rangordning förstärker små poängskillnader till verkliga anställningsutfall. Om pilotdata visar någon klyfta mellan språkversioner bör du överväga godkänd/underkänd-trösklar istället för detaljerade rangordningar tills du kan bevisa ekvivalens. Automatiserad poängsättning och AI-genererade rekommendationer förtjänar samma granskning; en poängsättningsalgoritm som beter sig annorlunda över språk är fortfarande ett urvalsförfarande och fortfarande ditt ansvar att övervaka. Sätt en omvalideringsutlösare, som en större jobbomdesign eller en förändring i din sökandepopulation, så att testet inte körs orört i år efter att rollen har förändrats. Talent Approveds guide till EEOC:s testningsskyldigheter bryter ner vilken dokumentation som typiskt håller under granskning.
Vad HR-team konsekvent gör fel när det gäller lokalisering
De flesta HR-team behandlar översättning som mållinjen istället för startpunkten. Det instinktet är förståeligt. Översättning känns konkret och kontrollerbar. Ekvivalenstestning känns abstrakt, och det är lätt att anta att en välöversatt uppgift automatiskt är en välfungerande uppgift.
Det är den inte. Ett vanligt integrationsmönster som vi ser fungera väl: pilottesta en rolls bedömning på två språk med en liten tvåspråkig grupp innan du rullar ut den i hela företaget, och jämför sedan genomförandetid och godkännandefrekvens innan du litar på poängen. Det enda pilottestet, även ett blygsamt, fångar de flesta problem som annars skulle dyka upp efter att en verklig kandidat har avslagits eller anställts baserat på en felaktig jämförelse.
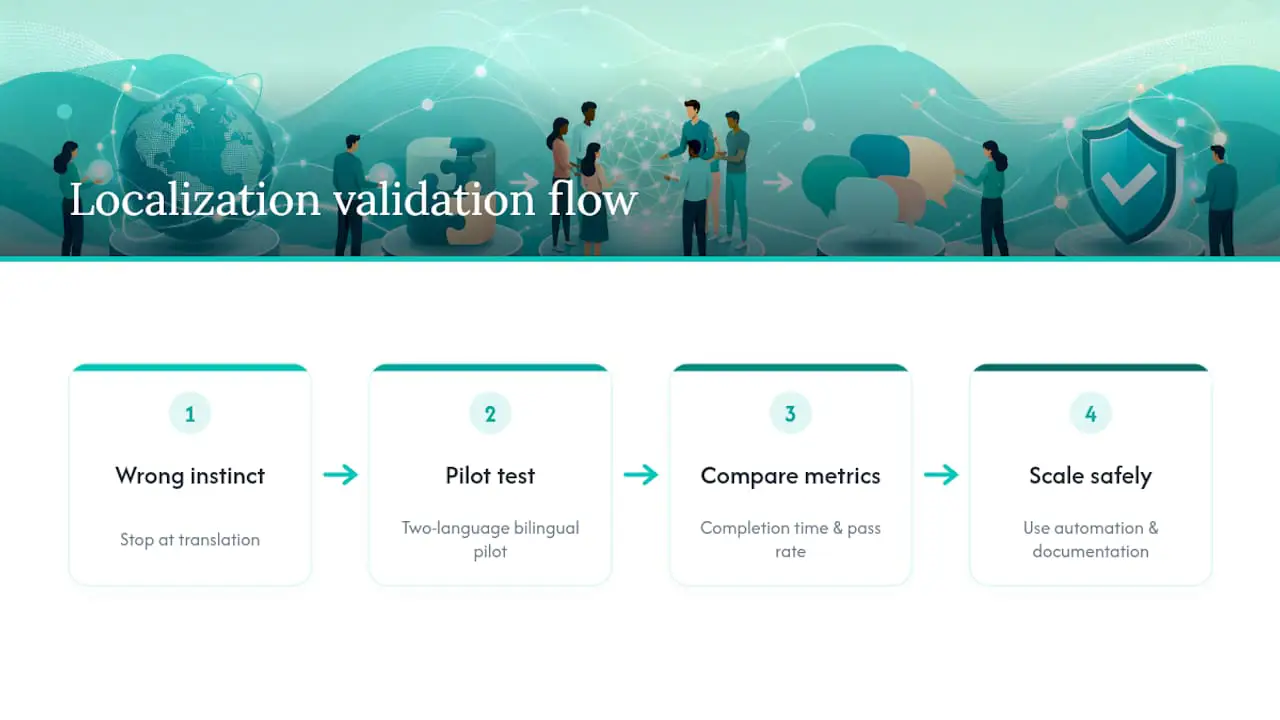
Den verkliga avvägningen är djupet av validering mot hastigheten att anställa. Fullständiga konstrukt-ekvivalensstudier tar tid som de flesta rekryteringsteam inte har för varje öppen roll. Det som hjälper till att täppa till det gapet utan att ta genvägar är automatisering som tar bort friktion på annat håll, som anti-fusk-övervakning och AI-genererade sammanfattningar som minskar granskarens arbetsbelastning, så att den tid som sparas på administration återinvesteras i pilot- och dokumentationsarbetet som faktiskt skyddar anställningen.
[brand_signal] [author_bio]
— Jimmie
Hur Talent Approved förenklar utrullning av flerspråkiga bedömningar
Att bygga en validerad, lokaliserad bedömning från grunden tar veckor när du börjar med ett tomt blad och ett kalkylblad. Talent Approveds funktion Magic Create bygger en skräddarsydd, rollspecifik bedömning på minuter från en jobbeskrivning eller kompetenslista, vilket ger dig en strukturerad startpunkt istället för en tom sådan, vilket frigör din tid för pilot- och ekvivalensarbetet som faktiskt spelar roll.
Varje bedömning du kör inkluderar inbyggd anti-fusk-övervakning, så att du jämför kandidatförmåga snarare än tillgång till sökmotorer eller en vän på högtalartelefon. AI-genererade sammanfattningar kondenserar resultat så att granskare inte manuellt behöver tolka varje svar över varje språkversion, vilket minskar granskningstiden utan att minska noggrannheten. Och eftersom prissättningen är pay-as-you-go på 5 dollar per genomförd kandidat utan prenumeration, kan du pilottesta en enda roll på två eller tre språk utan att binda dig till ett plattformsavtal innan du vet att versionerna håller.
Börja med en roll. Pilottesta den på de språk din kandidatpool faktiskt använder, samla in data om genomförandetid och godkännandefrekvens och fortsätt att dokumentera allt. Besök prissidan för kompetensbedömningar för att sätta upp din första lokaliserade bedömning och se resultaten med egna ögon.
Källor
- Anställningstester och urvalsförfaranden | U.S. Equal Employment Opportunity Commission
- eCFR :: 29 CFR Part 1607 – Enhetliga riktlinjer för urval av anställda (1978)
- Utvärdering av ekvivalensen hos en medarbetarattitydundersökning över språk, kulturer och administreringsformat
Vanliga frågor
Vad är en flerspråkig kompetensbedömning?
Det är ett rollspecifikt test av arbetsförmåga, såsom kodning, dataanalys eller kundtjänstscenarier, lokaliserat till en kandidats språk snarare än ett test av språkfärdighet i sig. Varje språkversion måste valideras separat som ett eget urvalsförfarande enligt EEOC:s vägledning.
Hur skiljer sig lokalisering från översättning?
Översättning konverterar ord; lokalisering bekräftar att testet fortfarande mäter samma färdighet efter att orden har ändrats. ITC:s riktlinjer kräver förenkling av källuppgifter, användning av tvåspråkig SME-granskning och pilottestning av varje version innan den behandlas som likvärdig med originalet.
Vilka statistiska kontroller bekräftar att språkversioner är ekvivalenta?
Analys av differentiell uppgiftsfunktion (DIF), ANCOVA och multidimensionell skalning är vanliga metoder som används för att jämföra hur uppgifter presterar över språk, tillsammans med enklare mätvärden som genomförandetid och godkännandefrekvens per språkgrupp, enligt forskning om certifieringsprovs ekvivalens.
Stödjer Talent Approved flerspråkiga bedömningar?
Ja. Talent Approved erbjuder flerspråkigt stöd tillsammans med sin funktion Magic Create, vilket låter HR-team bygga rollspecifika bedömningar och driftsätta dem över språk med inbyggd anti-fusk-övervakning och AI-genererade sammanfattningar. Prissättningen är pay-as-you-go på 5 dollar per genomförd kandidat, utan prenumerationskrav.
Vem är juridiskt ansvarig om ett lokaliserat test visar negativ inverkan?
Arbetsgivaren som administrerar testet är fortsatt ansvarig, även när en leverantör byggde det, enligt EEOC:s vägledning. Arbetsgivare bör hålla jobbanalysregister, pilotdata och valideringsbevis tillgängliga för att kunna demonstrera jobbrelevans enligt UGESP-standarder.