
Distribuer spørsmålsrandominiseringstester på minutter for lærere
Spørsmålsrandomisering presenterer en annen spørsmålsrekkefølge, svarssekvens eller oppgavesett for hver student, slik at det å kopiere en fasit eller kikke på naboens skjerm slutter å fungere. Den viktigste fordelen er færre muligheter for ulovlig deling, men teknikken forblir bare rettferdig når de underliggende spørsmålspoolene er bygget med tilsvarende vanskelighetsgrad og tilstrekkelig dybde til å unngå gjentakelser.
TL;DR:
- Randomisering fungerer best når spørsmålspoolene er dype og godt balanserte, med minst 100 til 200 elementer per 10 spørsmål for å minimere overlapp.
- Kombinasjon av flere randomiseringsteknikker øker vanskelighetsgraden for juks betydelig, særlig når spørsmål, svaralternativer og leveringsform varieres samtidig.
- Riktig oppsett innebærer å merke spørsmål etter læringsutbytte og vanskelighetsgrad, forhåndsvise med frø, og føre detaljerte registre over hvilken versjon hver student mottar.
- Bruk av mange små delpooler med et lavt spørsmål-til-pool-forhold er dokumentert å redusere overlapp og sekvensielle gjentakelser i store klasser.
- Automatiserte vurderinger som Talent Approved effektiviserer randomisering og juksforebyggende tiltak, og reduserer oppsettid merkbart samtidig som rettferdighet og sikkerhet ivaretas.
Innholdsfortegnelse
- Hva spørsmålsrandomisering er og hvorfor det er viktig
- Typer og teknikker for spørsmålsrandomisering
- Slik setter du opp randomisering i et LMS eller en vurderingsarbeidsflyt
- Beste designpraksis for å holde randomiserte tester rettferdige
- Implementeringssjekkliste: Innstillinger, metadata og kontroller på eksamensdagen
- Begrensninger ved randomisering og komplementære integritetsverktøy
- Bygg randomiserte, rollespesifikke tester uten manuelt oppsettarbeid
- Forfatterperspektiv: Hva som faktisk utgjør en forskjell
- Kilder
- Ofte stilte spørsmål
Hva spørsmålsrandomisering er og hvorfor det er viktig
Spørsmålsrandomisering dekker to beslektede grep: å stokke om rekkefølgen elementene vises i, og å hente spørsmål fra en større pool slik at ulike studenter ser helt forskjellige utvalg. Det første beskytter mot at noen kaster et blikk på naboens skjerm og sammenligner svarposisjon med svarposisjon. Det andre, ofte kalt randomly selected question exams (RSQE), beskytter mot en student som tok prøven i går og sender svarene på SMS til en venn som tar den i dag.
Institusjoner støtter seg på dette av tre praktiske grunner:
- Fjern- og nettbasert testing fjernet den fysiske kontrollen en eksamensovervåker tidligere hadde over et rom.
- Automatiserte retteystemer trenger strukturerte oppgaver, så randomisering skalerer uten å legge til manuelt gjennomgangsarbeid.
- Store kursseksjoner gjenbruker den samme oppgavebanken på tvers av gjennomføringer, og randomisering hindrer at dette gjenbruket blir en lekkasje.
Randomisering er ikke en erstatning for eksamensvakt eller plagiatdeteksjon. Det er et strukturelt lag som gjør de andre verktøyene mer effektive ved å redusere gevinsten av juks i utgangspunktet.
Typer og teknikker for spørsmålsrandomisering
Fire teknikker dekker det meste av det lærere trenger, og de kan kombineres.
- Stokk om spørsmålsrekkefølgen. Det samme settet med oppgaver vises i en annen rekkefølge for hver student, noe som avverger enkel juks ved å «sammenligne svarposisjoner».
- Stokk om svaralternativene. Innen et flervalgsoppgave roterer selve valgene, slik at «svaret er C» slutter å være nyttig informasjon å dele.
- Tilfeldig utvelgelse fra delpooler. I stedet for at alle studenter får de samme 40 spørsmålene, trekker hver student et knippe fra dusinvis av tilsvarende delpooler, slik at ingen to tester ser like ut.
- Levering av ett spørsmål om gangen. Studenter ser og besvarer ett element før det neste vises, noe som hindrer dem i å skanne hele eksamenen og samordne svar i sanntid.
Kombinasjon av alle fire øker kostnaden ved juks dramatisk, fordi en student ikke bare ville trenge å samordne svar, men også posisjoner, ordlyd og tempo med noen som tar en reelt annerledes prøve. En forbehold: noen oppgaver bør ikke stokkes om. Hvis et alternativ som «Ingen av de ovennevnte» alltid befinner seg sist, holder man den posisjonen fast mens resten stokkes om, slik at oppgaven forblir logisk sammenhengende.
Proffips: Kjør en stokket quiz i forhåndsvisningsmodus før du publiserer den. Fastsatte svaralternativer som ved et uhell ble stokket om, er den aller vanligste randomiseringsfeilen lærere rapporterer etter lansering.
Slik setter du opp randomisering i et LMS eller en vurderingsarbeidsflyt
De fleste læringsplattformer og undersøkelsesplattformer har allerede de kontrollene du trenger. Arbeidet handler mindre om å finne en skjult innstilling og mer om å organisere innholdet ditt slik at disse innstillingene oppfører seg forutsigbart.
- Bygg merkede oppgavebanker. Grupper spørsmål etter emne og vanskelighetsgrad, og merk hvert enkelt med det læringsutbyttet det måler, slik at et tilfeldig trekk likevel dekker riktig materiale.
- Angi trekkregler. Konfigurer «trekk X spørsmål fra denne poolen» per seksjon i stedet for å trekke fra én stor bank, og slå på stokking av svaralternativer der det gir mening.
- Forhåndsvis med et frø. Plattformer som Qualtrics dokumenterer funksjoner for å randomisere blokker som lar deg generere et prøvetrekk og bekrefte resultatet før studentene ser det.
- Lås det som skal låses. Fastsatte svarposisjoner og eventuelle tilretteleggingsrelaterte innstillinger (forlenget tid, skjermlesere) må overleve stokkingen urørt.
- Eksporter kartleggingen. Behold en oversikt over hvilket frø eller trekk som produserte hvilken versjon, slik at retting og klagebehandling refererer til nøyaktig den prøven en student tok.
Oppgavebanker i Canvas og lignende systemer er bygget for nettopp denne arbeidsflyten, og genererer et distinkt utvalg per student fra én felles bank. En Monte Carlo-studie av RSQE-design fant at antall delpooler og trekkforholdet direkte bestemmer hvor ofte to studenter ender opp med overlappende spørsmål, og det er derfor neste avsnitt tar for seg pooldybde i detalj.
Beste designpraksis for å holde randomiserte tester rettferdige
Randomisering fungerer bare hvis poolene den trekker fra er godt bygget. En grunn pool med fem elementer per delpool vil gjenta spørsmål konstant på tvers av en stor klasse, uansett hvor god stokkingsalgoritmen er.
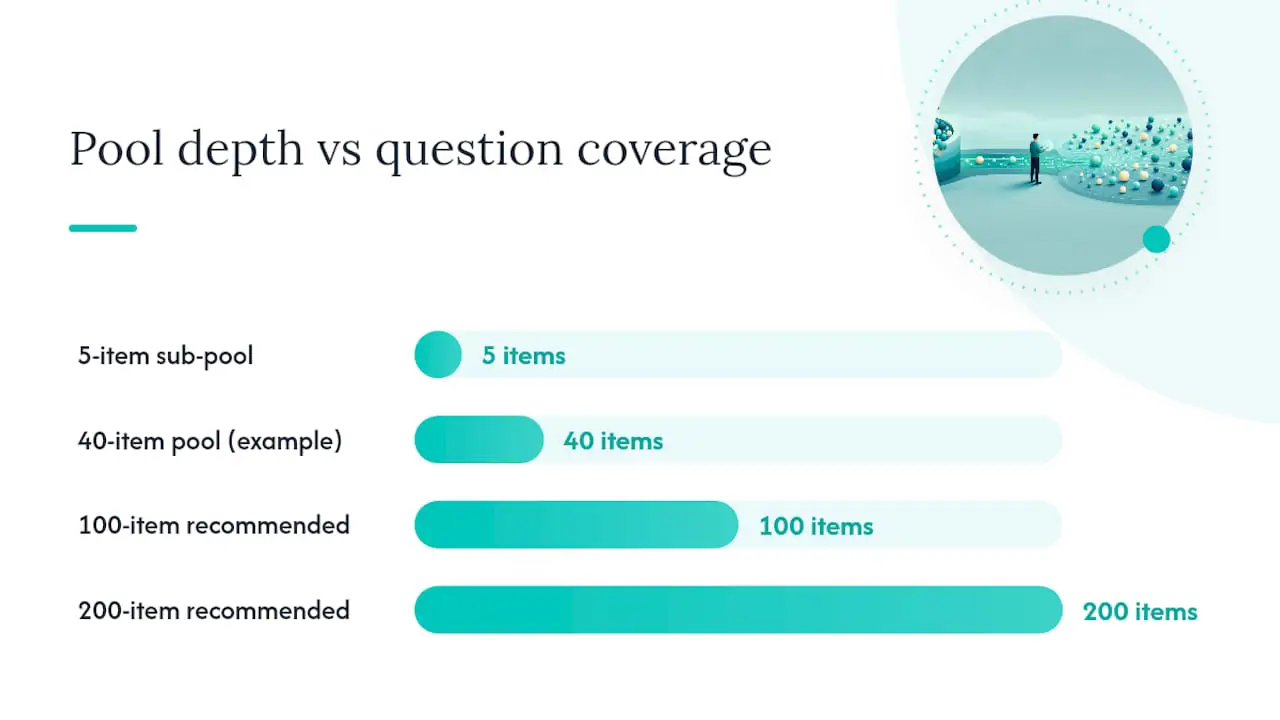
Det sterkeste belegget for dette kommer fra en Monte Carlo-analyse fra 2022 av 600 tilfeldig utvalgte spørsmålseksamener, som fant at bruk av mange delpooler med et lavt spørsmål-til-pool-forhold, i området 5 til 10 prosent, markant reduserer antall gjentatte og sekvensielt overlappende spørsmål mellom studenter. I praksis betyr det at en 10-spørsmåls eksamen fungerer bedre ved å trekke fra 100 til 200 delpoolelementer enn fra 40.
Dybde alene er ikke nok. Noen andre regler er like viktige:
- Hvert element i en delpool bør teste det samme læringsutbyttet på omtrent samme vanskelighetsgrad, slik at ingen student ved en tilfeldighet trekker en enklere eller vanskeligere versjon.
- Pensjonér og fyll på pooler etter hvert testvindu, særlig for kurs med høy påmelding der samme eksamen kjøres på tvers av flere seksjoner eller semestre.
- Hvis du genererer elementer fra maler, kjør en vanskelighetssjekk – historiske prestasjonsdata eller et simulert item response theory (IRT)-trekk – før det nye elementet legges til en aktiv pool.
Historiske eksperimenter med randomiserte flervalgseksamener har generelt funnet ingen målbar nedgang i gjennomsnittlig prestasjon når elementer er riktig kalibrert for vanskelighetsgrad. Dette funnet avhenger helt og holdent av å gjøre kalibreringsarbeidet først.
Implementeringssjekkliste: Innstillinger, metadata og kontroller på eksamensdagen
Behandle utrullingen som tre faser, ikke én stor konfigurasjonssesjon.
- Før eksamen: Merk hvert element etter emne, vanskelighetsgrad og læringsutbytte. Bygg delpooler med et lavt trekkforhold. Kjør en pilotforhåndsvisning og bekreft at fastsatte svarposisjoner overlever stokkingen.
- Under eksamen: Overvåk sesjonslogger mens studentene arbeider seg gjennom prøven, og bekreft at tilretteleggingstiltak – forlenget tid, skjermleserkompatibilitet – ble videreført gjennom randomiseringsinnstillingene uten å bli overstyrt.
- Etter eksamen: Eksporter den fullstendige frø-til-student-kartleggingen slik at du kan rekonstruere nøyaktig hvilken versjon hver student mottok. Kjør en grunnleggende skanning av svarsmønstre på tvers av innleveringer, og logg rettferdighetsmålinger for gjennomgang.
Proffips: Lagre frø-til-student-kartleggingen samme dag du avholder eksamen, ikke når en omrettingsforespørsel kommer inn tre uker senere. Det blir vanskeligere å rekonstruere hvilken versjon en student tok jo lenger du venter.
Team som håndterer store kull folder ofte denne sjekklisten inn i en bredere arbeidsflyt for høyvolumsbaserte vurderinger slik at trinnene på eksamensdagen blir rutine snarere enn et engangskaos hver testsyklus.
Begrensninger ved randomisering og komplementære integritetsverktøy
Randomisering innsnevrer muligheten for juks. Den oppdager det ikke i ettertid, og den garanterer ikke at alle versjoner av prøven er like vanskelige.
- Statistisk deteksjon er fortsatt viktig. En randomiserings-p-verditest kan flagge mistenkelig like svarsmønstre mellom studenter selv når spørsmålene selv ble stokket om eller trukket fra ulike delpooler.
- Kombiner det med eksamensvakt og logger. Sesjonsopptak og tidsstemplede aktivitetslogger fanger opp atferd som randomisering alene ikke kan avdekke, som et nettleserfaneskifte midt i eksamen.
- Sjekk rettferdighet med IRT. En analyse fra University of Illinois som brukte item response theory-simuleringer på tvers av 100 permutasjoner og 500 kjøringer per student, fant at de fleste randomiserte pooleksamener var rimelig rettferdige, ved å bruke måleparametere som gjennomsnittlig absolutt avvik for å flagge når et bestemt pooltrekk er for lett eller for vanskelig.
Når en rettferdighetskontroll avdekker et problem, er løsningen vanligvis å redesigne delpoolene, ikke å gi opp randomisering helt.
Bygg randomiserte, rollespesifikke tester uten manuelt oppsettarbeid
Alt som er beskrevet ovenfor – merking av elementer, bygging av delpooler, låsing av fastsatte svar, sporing av hvilken versjon hver person mottok – tar reelle timer å konfigurere manuelt. Talent Approved reduserer det oppsettet til minutter. Magic Create-funksjonen bygger en rollespesifikk ferdighetsvurdering direkte fra en stillingsbeskrivelse eller en liste over ferdigheter, og trekker deretter på gjenbrukbare spørsmålsbiblioteker slik at du ikke starter fra en tom pool hver gang du ansetter.
Plattformens juksforebyggende lag – skjerm- og webkameraovervåking, sesjonsavspillinger og full frø-kartlegging – håndterer den operative delen av sjekklisten automatisk, og AI-genererte sammendrag betyr at du ikke manuelt trenger å gjennomgå hver kandidats råsvar for å vurdere rettferdighet eller flagge avvik. Fordi Talent Approved tar 5 dollar per fullført kandidatvurdering uten abonnement, får team som kjører høyvolums ansettelsesrunder den samme randomiserte, sikre testinfrastrukturen beskrevet i denne veiledningen uten å betale for programvare de bruker to ganger i året. Begynn å bygge en vurdering og se hvor raskt en stillingsbeskrivelse blir til en live, manipulasjonsresistent test.
Forfatterperspektiv: Hva som faktisk utgjør en forskjell
De fleste team overinvesterer i stokkingsinnstillinger og underinvesterer i pooldybde. En bred delpool med et lavt trekkforhold gjør mer for rettferdigheten enn noen stokkingsveksler. Start høyinnsatsvurderinger med flere delpooler enn det som føles nødvendig, pilottest dem, og la data om rettferdighet etter eksamen – ikke intuisjon – fortelle deg hvor poolene er for tynne.
— Jimmie
Kilder
- Stokking av spørsmål og svaralternativer i Canvas-quizer
- Praktisk design av eksamener med tilfeldig utvalgte spørsmål for å håndtere gjentatte og sekvensielle spørsmål i nettbaserte eksamener
- Er vi rettferdige? Kvantifisering av poengpåvirkning av informatikkeksamener med randomiserte spørsmålspoler
Ofte stilte spørsmål
Hva er en randomiseringstest?
I vurderingsdesign refererer en randomiseringstest til å presentere ulike spørsmålsrekkefølger, svarssekvenser eller oppgavesett for hver testdeltaker, ofte kombinert med en statistisk randomiserings-p-verditest som brukes i etterkant for å oppdage mistenkelig likhet i svarsmønstre mellom studenter.
Hva betyr det at et spørsmål er randomisert?
Et randomisert spørsmål vises enten på en annen posisjon for hver testdeltaker, har stokket om svaralternativene sine, eller er trukket fra en pool av tilsvarende elementer slik at ulike studenter kanskje ikke engang ser det samme spørsmålet i det hele tatt.
Hva er de fem typene prøvespørsmål som oftest randomiseres?
Flervalg, sant/usant, sammenkoblingsoppgaver, fyll-inn-det-tomme og kortsvaroppgaver randomiseres alle ofte, selv om flervalg får den mest sofistikerte behandlingen siden både spørsmålsrekkefølge og rekkefølge på svaralternativene kan stokkes uavhengig av hverandre.
Hvordan randomiserer jeg spørsmål uten å gjøre testen urettferdig?
Bruk mange delpooler med et lavt spørsmål-til-pool-forhold, generelt 5 til 10 prosent, og bekreft at hvert element i en delpool tester det samme læringsutbyttet på tilsvarende vanskelighetsgrad før det går live.
Kan Talent Approved randomisere vurderingsspørsmål automatisk?
Ja. Talent Approvedss gjenbrukbare spørsmålsbiblioteker og Magic Create-funksjonen lar rekrutterere bygge rollespesifikke vurderinger med randomisert elementutvelgelse og innebygd juksforebyggende overvåking – uten å manuelt konfigurere pooler fra bunnen av.